Generatív AI lexikon 2026: képgenerálás, videó, zene, LLM és jog | Oloren
Oloren blog, 2026. szeptember

Generatív AI lexikon 2026: kép, videó, zene, nyelvi modellek és a jog

Hogyan működnek a kép-, videó-, zene- és nyelvi modellek, mire tanítják őket, hogyan jelölik a kimenetet, és mit ír elő a 2026-os európai és magyar szabályozás. Szakmai lexikon algoritmusokkal, ábrákkal és 2026-os adatokkal.

Miről szól ez a lexikon?

A generatív mesterséges intelligencia 2026-ra a tartalomgyártás mindennapi eszköze lett, a körülötte lévő tudás viszont szétszórt: a technikai leírások angolul és tanulmányokban, a jogi szabályok rendeletekben és ítéletekben, a platformszabályok súgóoldalakon. Ez a cikk egy helyre gyűjti, amit egy megrendelőnek, marketingesnek vagy alkotónak érdemes tudnia: hogyan működnek a kép-, videó-, zene- és nyelvi modellek (algoritmusokkal), mire tanítják őket és hogyan címkézik az adatot, hogyan jelölik a kimenetet, mit ír elő az EU AI-rendelet 2026. augusztus 2-tól, hol tart a magyar szabályozás és a bírósági gyakorlat, és hogyan választ forrást egy AI-kereső.

A statisztikák és piaci adatok kizárólag 2026-os forrásból származnak, az alapalgoritmusoknál a klasszikus tanulmányok neve és éve szerepel. Azt, hogy mindez hogyan néz ki a mi gyártási gyakorlatunkban (mit generálunk, mit nem, hogyan dolgozik egy tanult filmes a modellekkel), az AI tartalomgyártás szolgáltatásoldalon írjuk le.

Hogyan működnek a képgeneráló modellek?

Hogyan működnek a képgeneráló modellek?

Diffúziós modell: zajból kép

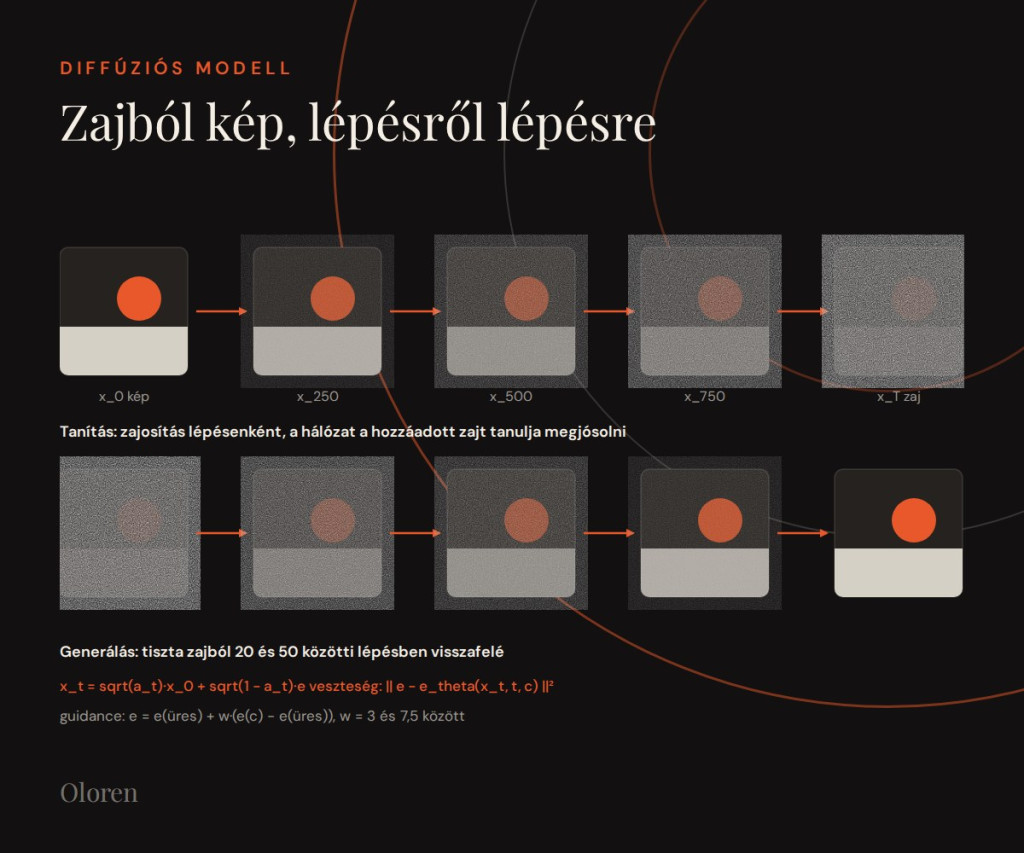
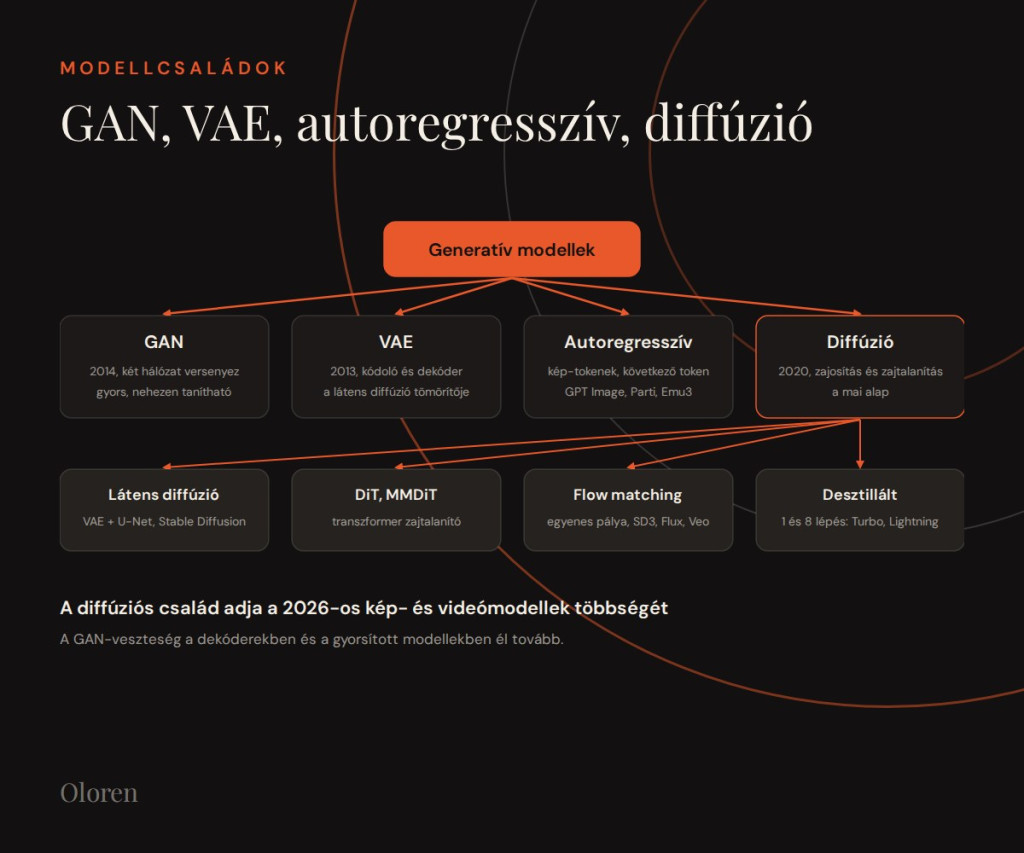
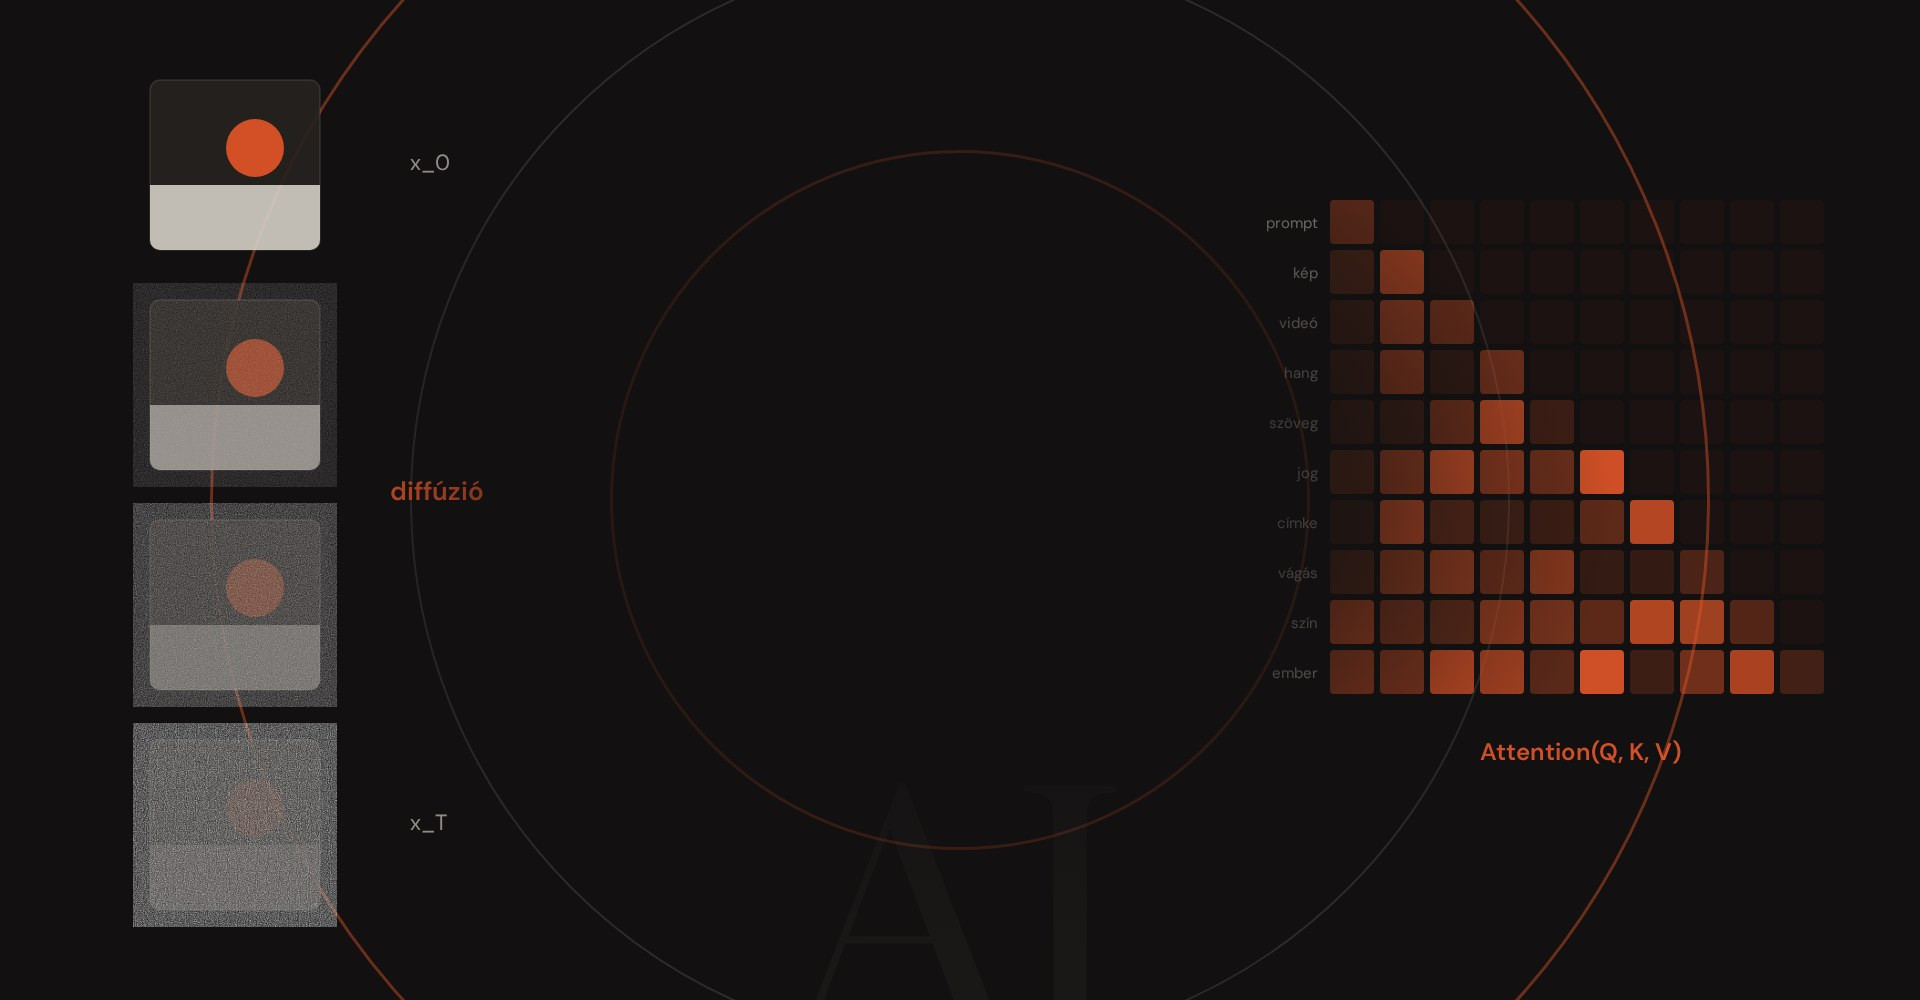
A 2026-ban használt képgenerátorok többsége diffúziós elven működik (DDPM, Ho és társai, 2020). A tanítás során a modell egy tiszta képhez lépésenként egyre több véletlen zajt ad, amíg a kép teljesen zajjá válik, és közben megtanulja megjósolni, hogy egy adott zajos állapotban mennyi zaj van a képen. Generáláskor a folyamat megfordul: tiszta zajból indulunk, és a hálózat lépésről lépésre eltávolítja a megjósolt zajt, amíg kép nem marad.

Az algoritmus tanító lépése: x_t = sqrt(a_t) * x_0 + sqrt(1 - a_t) * e, ahol x_0 a tiszta kép, e a zaj, a_t a zajütemterv; a hálózat a || e - e_theta(x_t, t, c) ||^2 veszteséget minimalizálja, c a szöveges feltétel. Generáláskor (DDIM-mintavétel) 20 és 50 közötti lépés is elég az eredeti 1000 helyett.

A prompt erejét a classifier-free guidance szabályozza: a hálózat kétszer fut, feltétellel és feltétel nélkül, és a kettő különbségét egy w szorzóval felnagyítjuk (e = e(üres) + w * (e(c) - e(üres))). Nagyobb w hűbb, de kevésbé változatos és könnyen túltelített képet ad; a gyakorlatban 3 és 7,5 közötti érték a tipikus.

Hogyan működnek a képgeneráló modellek?

Látens tér: a kép tömörített formája

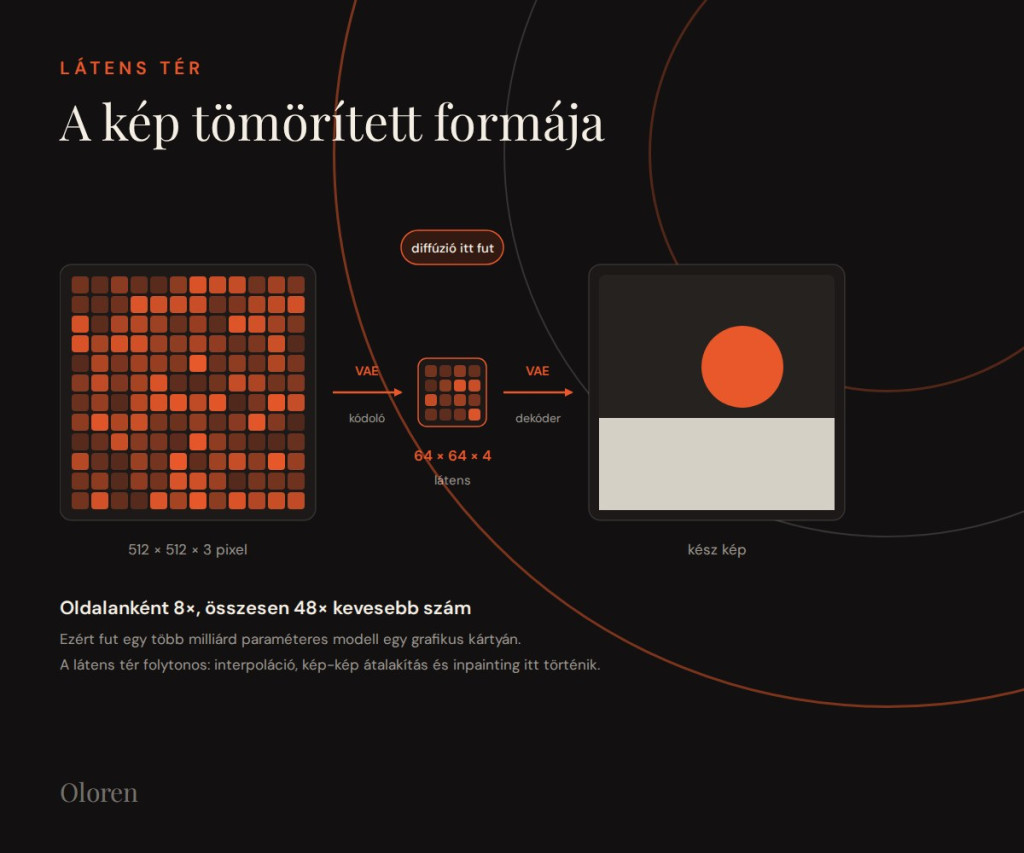
A diffúzió nem a pixeleken, hanem egy tömörített reprezentációban fut (latent diffusion, Rombach és társai, 2021). Egy variációs autoenkóder (VAE) a 512×512×3 pixeles képet 64×64×4 értékre sűríti, tehát oldalanként nyolcszorosára, összesen nagyjából 48-szor kevesebb számra. A zajosítás és a zajtalanítás ebben a látens térben történik, a végén a VAE dekódere állítja vissza a pixeleket.

Ez teszi lehetővé, hogy egy több milliárd paraméteres modell egyetlen grafikus kártyán fusson, és ezért nevezik ezt a modellcsaládot látens diffúziónak. A látens tér folytonos: két pont között interpolálva értelmes köztes képek jönnek létre, ez az alapja a variációknak, a kép-kép átalakításnak és az inpaintingnek (a kép egy részének újragenerálása maszk mentén).

Hogyan működnek a képgeneráló modellek?

Szövegkódoló és keresztfigyelem: hogyan kerül a prompt a képbe

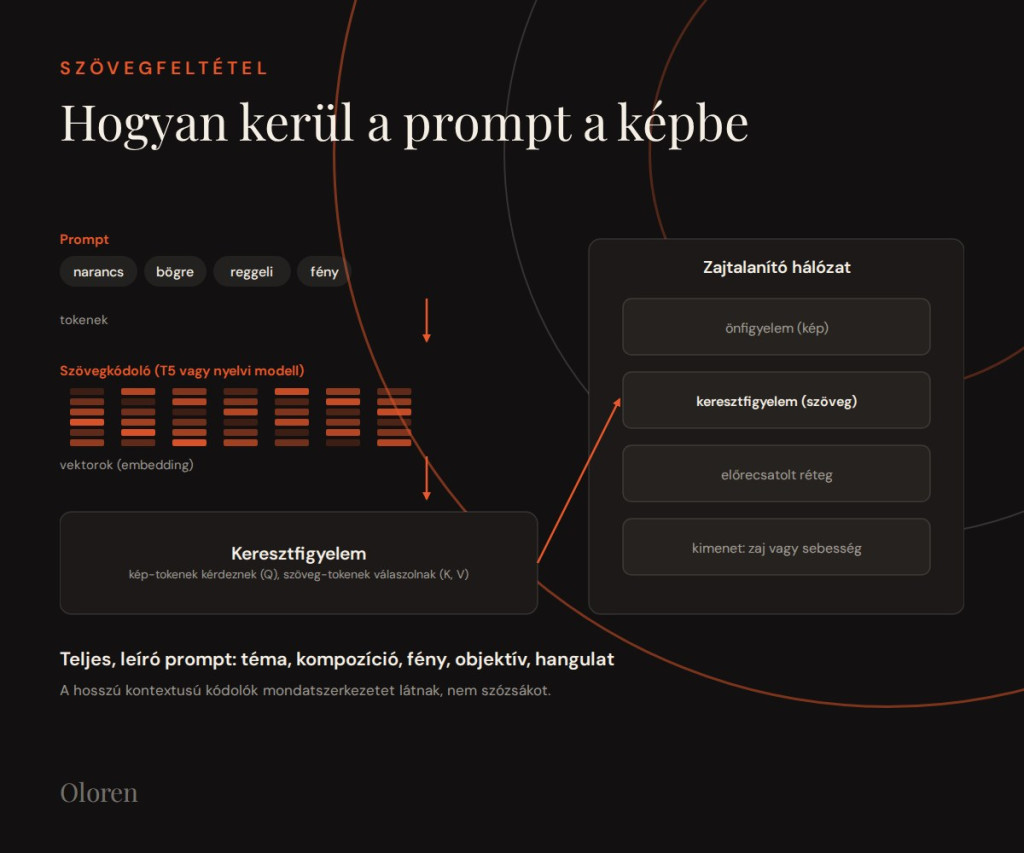
A promptot először tokenekre bontjuk, majd egy szövegkódoló (a korai modellekben CLIP, ma T5 vagy egy nyelvi modell) minden tokenhez egy számvektort rendel. Ezek a vektorok a zajtalanító hálózat figyelemrétegeibe kerülnek: a kép-tokenek "kérdeznek" (query), a szöveg-tokenek "válaszolnak" (key, value), így a hálózat minden képrészletnél tudja, melyik szó vonatkozik rá.

A képminőség szövegrenderelésben és összetett kompozíciókban azért javult 2024 óta látványosan, mert a rövid, 77 tokenes CLIP-kódolót hosszú kontextusú nyelvi modellek váltották fel: a modell már nem szózsákot, hanem mondatszerkezetet lát. A gyakorlatban ezért írunk teljes, leíró promptot (téma, kompozíció, fény, objektív, hangulat), nem kulcsszólistát.

Hogyan működnek a képgeneráló modellek?

Flow matching és diffúziós transzformer

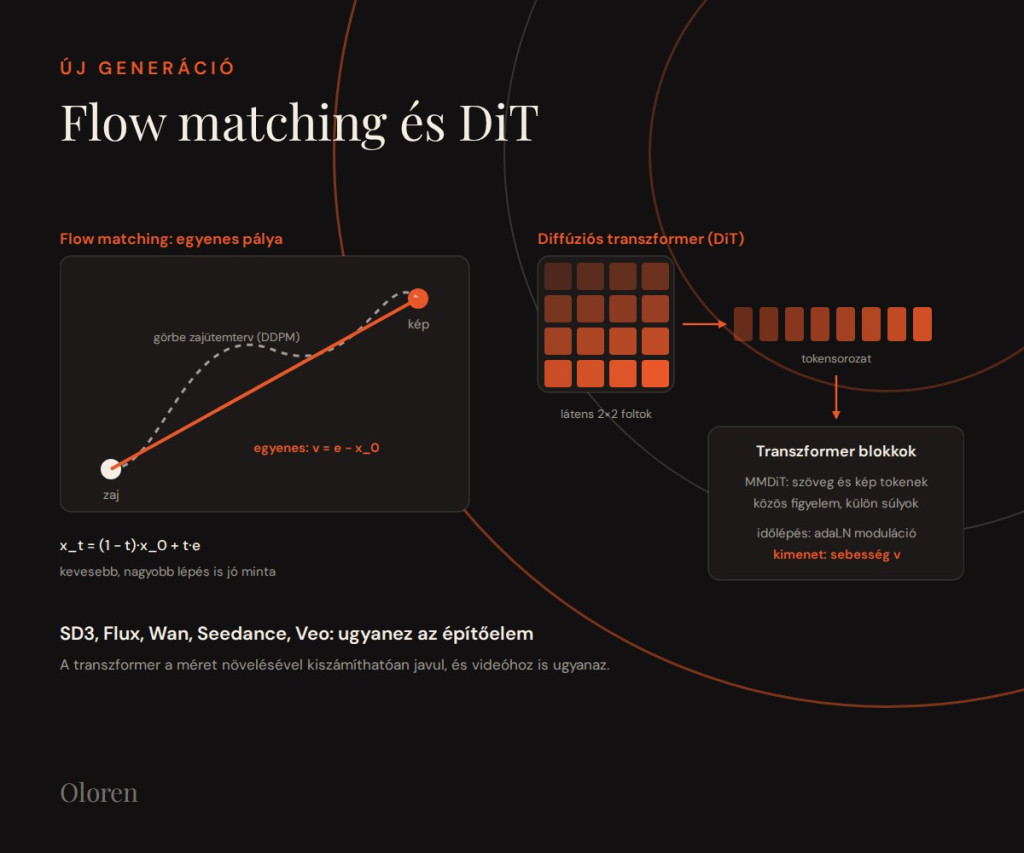
A 2025 és 2026 közötti kép- és videómodellek (Stable Diffusion 3, Flux, Wan, Seedance, Veo) két újítást hoztak. A flow matching (Lipman és társai, 2022) a görbe zajütemterv helyett egyenes vonalat húz a kép és a zaj közé, és a modell ennek az egyenesnek a sebességét tanulja: x_t = (1 - t) * x_0 + t * e, cél v = e - x_0. Az egyenes pálya miatt kevesebb, nagyobb lépéssel is jó a minta.

A diffúziós transzformer (DiT, Peebles és Xie, 2022) a korábbi U-Net hálózatot cseréli le: a látens képet 2×2-es foltokra (patch) vágja, ezekből tokensorozat lesz, és egy szabványos transzformer dolgozza fel. Az MMDiT-változat (SD3, Flux) a szöveg- és kép-tokeneket egy közös figyelemblokkban, de külön súlykészlettel kezeli, így a két modalitás kétirányban kommunikál. A transzformer előnye, hogy a méret növelésével kiszámíthatóan javul, és ugyanaz az építőelem szolgál videóhoz is.

Hogyan működnek a képgeneráló modellek?

GAN, VAE, autoregresszív: a többi modellcsalád

GAN (Goodfellow és társai, 2014): két hálózat versenyez, a generátor képet gyárt, a diszkriminátor valódit és hamisat különböztet meg. Egy lépésben generál, ezért gyors, de nehezen tanítható; ma a VAE-dekóderek és a gyorsított, kevés lépéses modellek belső veszteségeként él tovább.

VAE (Kingma és Welling, 2013): kódoló és dekódoló, közte egy szabályozott látens eloszlás. Önmagában elmosódott képet ad, de ez a látens diffúzió tömörítő szakasza.

Autoregresszív token-modell (VQ-VAE, VQGAN, Parti, Emu3): a képet egy tanult kódkönyv egész számaira bontja, és egy nyelvi modell ugyanúgy jósolja a következő kép-tokent, mint a következő szót. Ezen az elven működik az OpenAI GPT Image vonala is, amely a nyelvi modellbe natívan épített képgenerátor: pontos szöveget ír a képre és többkörös szerkesztést tud, cserébe lassabban, sorosan dekódol.

Konzisztencia- és desztillált modellek (Song és társai, 2023): egy többlépéses "tanár" modell kimenetét egy "diák" 1 és 8 közötti lépésben tanulja meg utánozni. Ezek a Turbo, Lightning és Fast változatok, amelyek másodpercek alatt adnak előnézetet.

A diffúziós generálás lépésről lépésre

Egy szöveg-kép generálás a gyakorlatban a következő lépésekből áll. 1. Tokenizálás: a prompt tokensorozattá alakul. 2. Kódolás: a szövegkódoló minden tokenhez vektort rendel. 3. Inicializálás: a látens térben véletlen zajt sorsolunk (a "seed" ennek a kiindulópontja, ezért ismételhető ugyanaz a kép ugyanazzal a seeddel). 4. Zajtalanítási ciklus: 20 és 50 közötti lépésben a hálózat megjósolja a zajt vagy a sebességet, a guidance felerősíti a prompt hatását, és a minta egy lépéssel közelebb kerül a tiszta képhez. 5. Dekódolás: a VAE a látens értékekből pixeleket állít elő. 6. Utófeldolgozás: biztonsági szűrő, láthatatlan vízjel (például SynthID), aláírt eredetadat (C2PA), felskálázás.

Ami ebből a gyártásban számít: a seed és a lépésszám rögzítése ismételhetővé teszi az eredményt; a guidance értéke a hűség és a változatosság közötti kompromisszum; a látens tér mérete (1K, 2K, 4K kimenet) a részletgazdagságot és a futásidőt egyszerre határozza meg; a vízjel és az eredetadat pedig a 2026-os jelölési kötelezettség technikai alapja.

Mire tanítják a modelleket, és hogyan címkézik az adatokat?

Mire tanítják a modelleket, és hogyan címkézik az adatokat?

Kép és szöveg párok: a tanítóadat

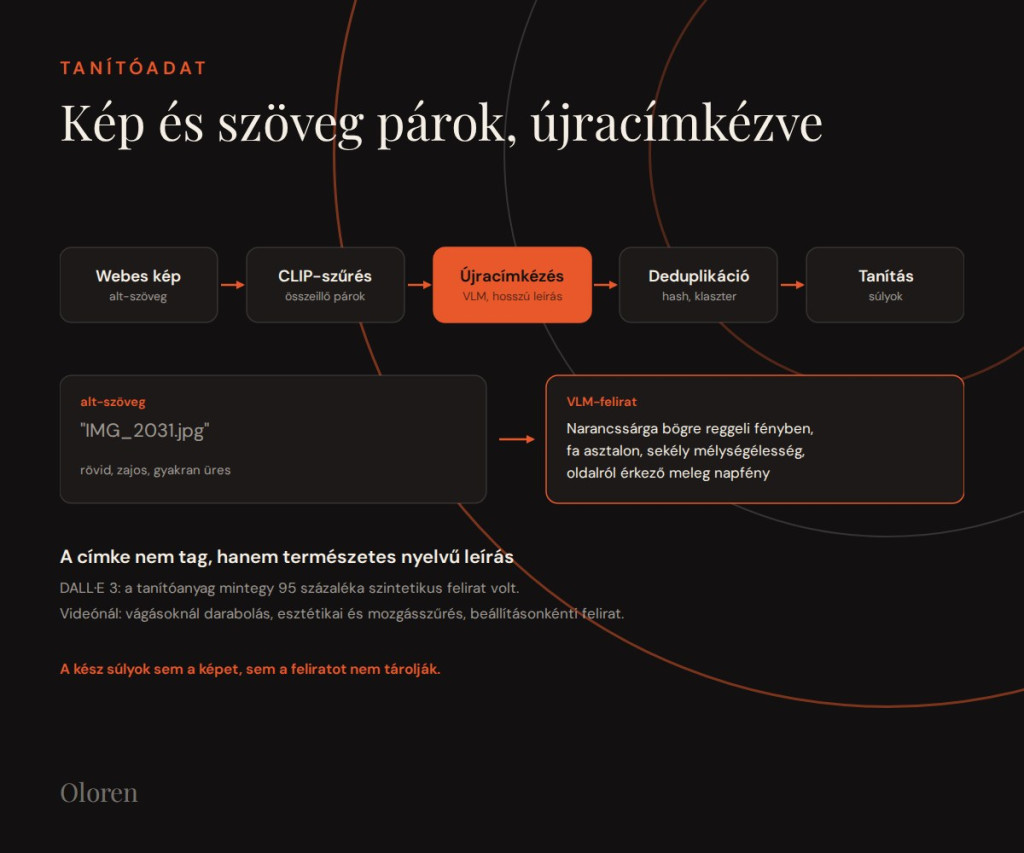
A képmodellek tanítóanyaga kép és szöveg párokból áll. A nyilvános adathalmazok (például a LAION-5B, 5,85 milliárd pár) webes lekaparásból származnak: a kép mellé az oldal alt-szövege kerül, majd egy CLIP-hasonlósági küszöb szűri ki a nem összeillő párokat. Az alt-szöveg rövid és zajos, ezért a laborok ma újracímkéznek: egy kép-szöveg modell (VLM) hosszú, részletes leírást ír minden képhez. Az OpenAI DALL·E 3 dokumentációja szerint a tanítóanyag mintegy 95 százaléka ilyen szintetikus felirat volt, és ez adta a jobb promptkövetést.

Videónál a klipeket vágásoknál darabolják, esztétikai, mozgás- és szövegszűrőkön futtatják, majd beállításonként feliratozzák. A címke tehát nem "tag" egy adatbázisban, hanem természetes nyelvű leírás, amelyből a modell a szöveg és a látvány együttes eloszlását tanulja meg. A modell a kész súlyokban nem tárolja sem a képet, sem a feliratot.

Mire tanítják a modelleket, és hogyan címkézik az adatokat?

CLIP: a híd a szöveg és a kép között

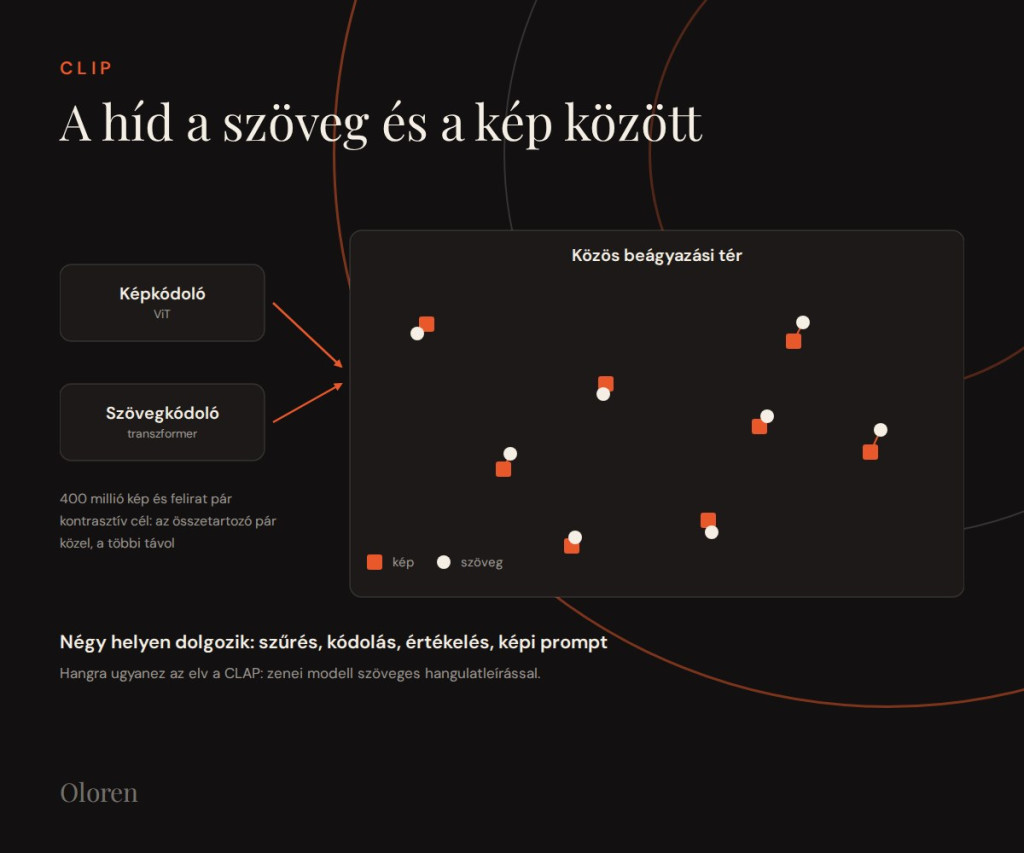
A CLIP (Radford és társai, 2021) két kódolót tanít egyszerre: egy képkódolót és egy szövegkódolót, 400 millió képfelirat-páron, kontrasztív céllal. Az összetartozó kép és szöveg vektora közel kerül egymáshoz egy közös térben, a nem összetartozóké távol. Ez az egyszerű elv négy helyen dolgozik a mai rendszerekben: a tanítóadat szűrésében, a korai modellek szövegkódolójaként, a kimenet értékelésében (CLIP-score), és a képi promptok (IP-Adapter, referenciakép) bemeneteként.

Ugyanez az ötlet audióra is működik (CLAP), ezért lehet egy zenei modellt szöveges hangulatleírással vezérelni.

Mire tanítják a modelleket, és hogyan címkézik az adatokat?

Súlyok, nem fájlok: miért nem vág össze képeket a modell

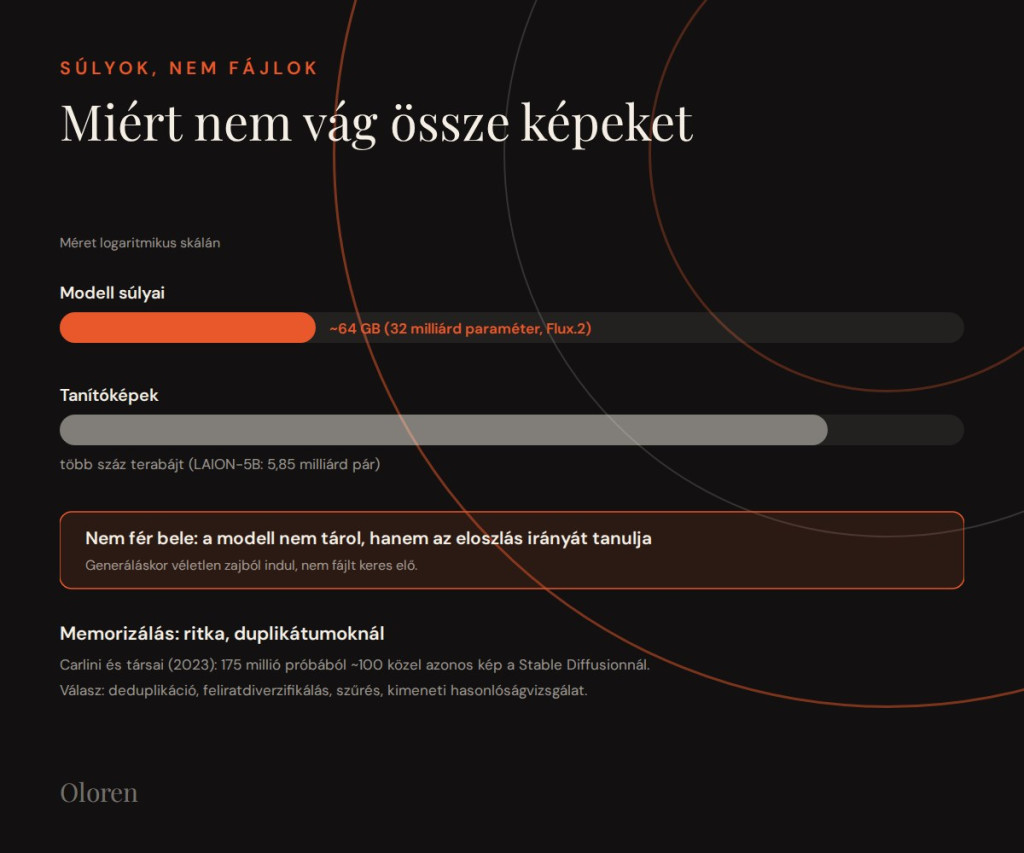
A tanítás nem másol, hanem a hálózat paramétereit (súlyait) állítja be úgy, hogy a zajtalanító a tanítóeloszlás irányát jósolja. A méretek beszédesek: egy 32 milliárd paraméteres képmodell (Flux.2) félpontosságban nagyjából 64 gigabájt, a tanítóképek pedig több száz terabájtot tesznek ki. A súlyokba fizikailag nem fér bele az adathalmaz, a modell ezért nem tud "kikeresni" egy fájlt.

A memorizálás ettől még létezik, de ritka és a duplikátumokra koncentrálódik: Carlini és társai (2023) 175 millió próbából körülbelül száz, a tanítóképpel közel azonos kimenetet találtak a Stable Diffusionnál, jellemzően sokszor ismétlődő képeknél. A laborok erre deduplikációval, feliratdiverzifikálással, híres művek és személyek szűrésével, valamint kimeneti hasonlóságvizsgálattal válaszolnak. Jogi szempontból viszont pont ez a memorizálás a 2025 és 2026 közötti európai ítéletek középpontja, erről a jogi fejezetben írunk.

Mire tanítják a modelleket, és hogyan címkézik az adatokat?

Irányítás: ControlNet, LoRA, referenciakép

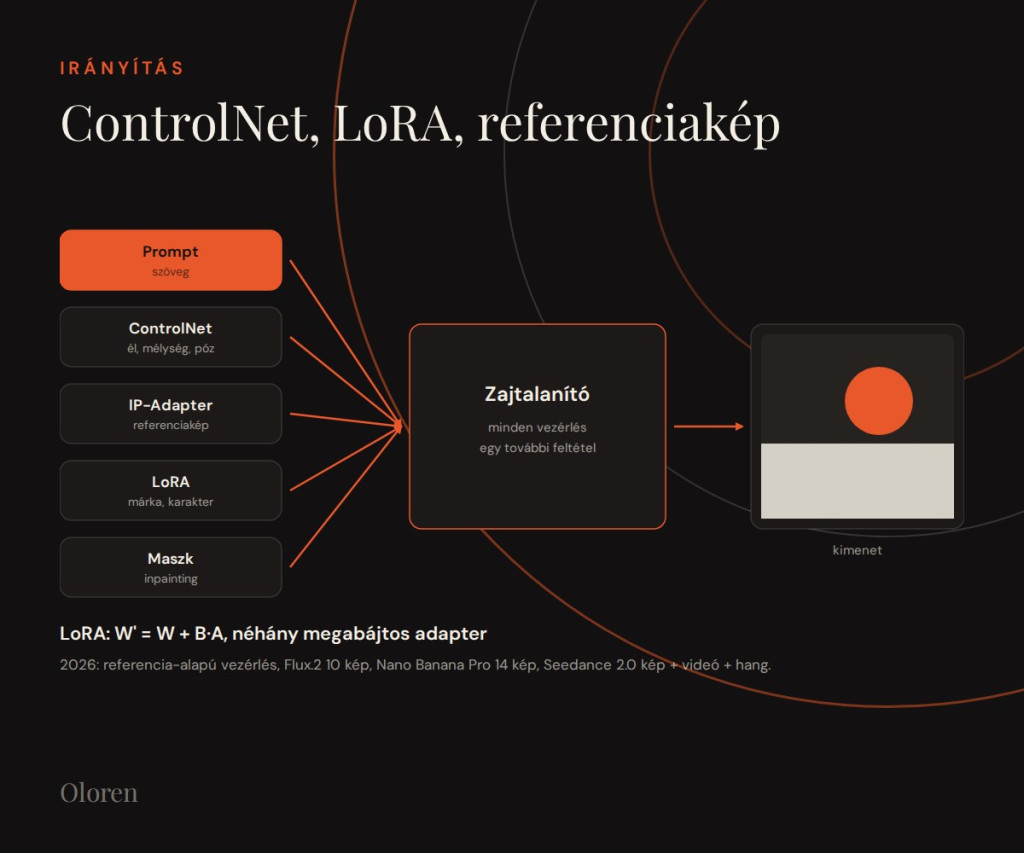
A szakszerű használat nem a promptban, hanem a feltételekben dől el. Minden vezérlés egy további jelet ad a zajtalanítónak. Kép-kép (SDEdit): a bemeneti képet részben zajosítjuk és onnan folytatjuk, az erősség szabja meg, mennyi marad az eredetiből. Inpainting és outpainting: a maszk mentén csak a kijelölt rész generálódik újra. ControlNet (Zhang és társai, 2023): él-, mélység- vagy póztérképet ad be egy párhuzamos hálózatágon, így a kompozíció rögzíthető, a stílus szabad marad. IP-Adapter: egy referenciakép CLIP-vektora külön figyelemágon érkezik, ez a "képi prompt". LoRA (Hu és társai, 2021): a modell súlyait nem írjuk át, hanem egy alacsony rangú kiegészítést tanítunk (W' = W + B·A), néhány megabájtos adapter egy termékhez, karakterhez vagy márkastílushoz. DreamBooth: 3 és 5 közötti fotóból egy ritka tokenhez köti a témát.

A 2025 és 2026 közötti csúcsmodellek ezt referencia-alapú, kontextusban tanuló vezérléssé egyszerűsítik: a Flux.2 legfeljebb 10, a Nano Banana Pro legfeljebb 14 referenciaképet (5 személy azonosságát) tart meg, a Veo 3.1 "Ingredients", a Kling 3.0 "Elements", a Seedance 2.0 pedig képet, videót és hangot is elfogad referenciaként. Ez teszi lehetővé a márkaelemek, a termék és a szereplő konzisztenciáját beállításról beállításra.

Videógenerálás: az idő a harmadik dimenzió

Videógenerálás: az idő a harmadik dimenzió

3D VAE és tér-idő tokenek

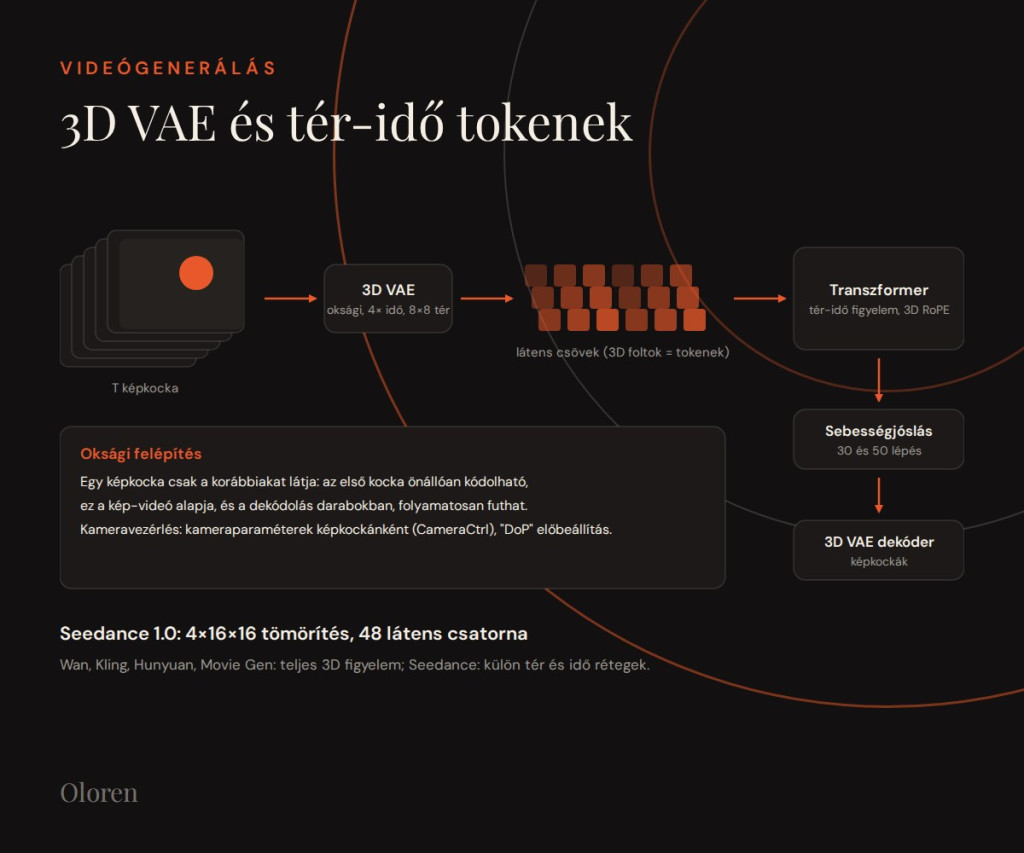
A videómodell ugyanaz a látens diffúziós elv, kiegészítve az idővel. Egy 3D, oksági (kauzális) VAE a képkockákat térben és időben is tömöríti: a Wan 2.1 időben 4-szeresen, térben 8×8-szorosan, a Seedance 1.0 4×16×16 arányban, 48 látens csatornával. Az oksági felépítés miatt egy képkocka csak a korábbiakat látja, ezért az első kocka önállóan kódolható, ez a kép-videó (image-to-video) alapja.

A látens videót 3D foltokra, "csövekre" vágjuk (például 1×2×2 látens voxel egy token), minden token 3D pozíciókódot kap (idő, y, x), majd egy diffúziós transzformer teljes tér-idő figyelemmel dolgozza fel a szöveg-tokenekkel együtt (Wan, Kling, Hunyuan Video, Movie Gen), vagy szétválasztott térbeli és időbeli figyelemrétegekkel (Seedance 1.0). A kimenetet flow matching sebességjóslással 30 és 50 közötti lépésben, vagy desztillálva néhány lépésben számoljuk, végül a 3D VAE dekódere adja vissza a képkockákat. A kameramozgás vezérléséhez a kameraparamétereket képkockánként Plücker-sugarakként kódolják (CameraCtrl, 2024), a termékekben ez "director" vagy "DoP" előbeállításként jelenik meg.

Videógenerálás: az idő a harmadik dimenzió

Natív hang és több beállítás egy generálásban

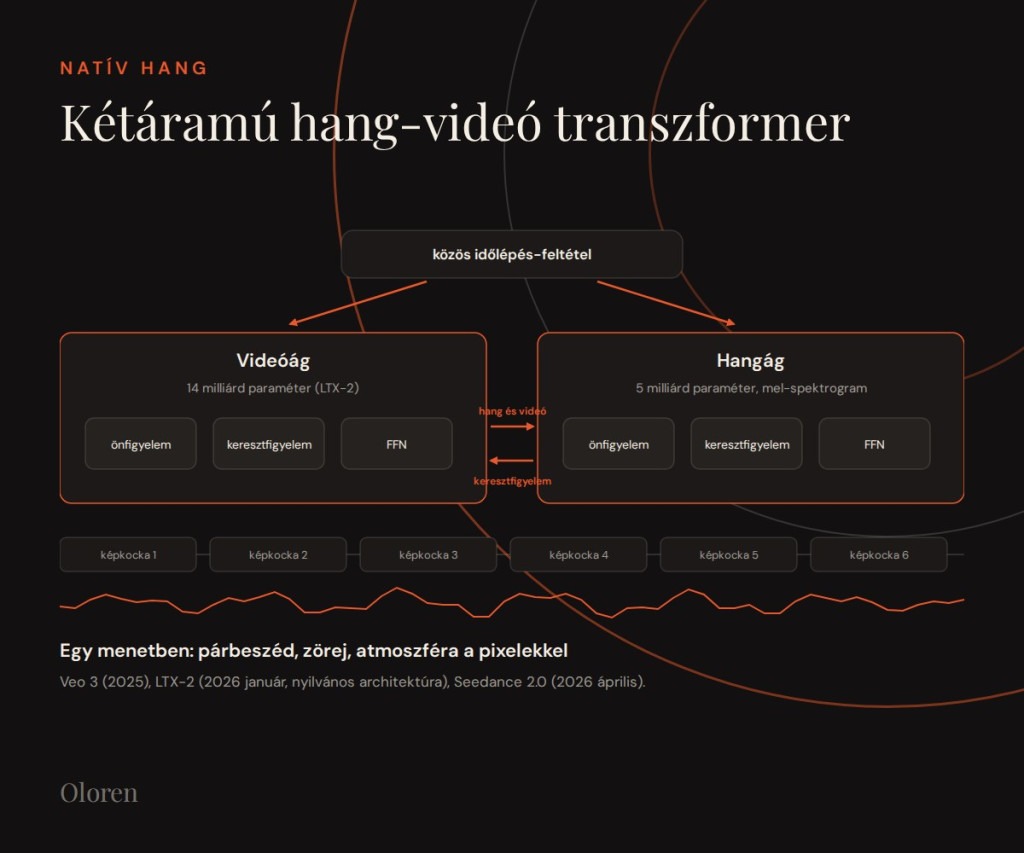
A Veo 3 (2025 május) volt az első elterjedt modell, amely a párbeszédet, a zörejt és az atmoszférát a pixelekkel egy menetben állította elő. A nyilvános architektúra erre az LTX-2 (Lightricks, 2026 január): aszimmetrikus, kétáramú transzformer, 14 milliárd paraméteres videóág és 5 milliárd paraméteres hangág (mel-spektrogram látens, egy token nagyjából 1/25 másodperc), a kettőt kétirányú hang-videó keresztfigyelem köti össze közös időlépés-feltétellel. A Seedance 2.0 (2026 április) szöveg, kép, hang és videó referenciát is elfogad egy egységes hang-videó generálásban.

A hosszabb, több beállításos anyag három úton készül: a modell az előző klip utolsó másodpercéből folytat (Veo 3.1 "extend"), natívan több beállítást tanul beállításonkénti pozíciókódolással és storyboard-szintű prompttal (Seedance, Kling 3.0 Omni), vagy egy menetben hosszabb kontextust kezel (Wan 3.0 és Seedance 2.5: 30 másodperc). A szereplők és tárgyak azonosságát referenciakötés ("Elements", "Ingredients") tartja beállításról beállításra.

A 2026-ban elérhető videómodellek

A táblázat a 2026 szeptemberében nyilvánosan dokumentált képességeket foglalja össze. Az értékek a gyártók saját közlései, a modellek gyorsan változnak, ezért a projekt indításakor mindig újraellenőrizzük.

Képmodellek 2026-ban: Google Nano Banana Pro és Nano Banana 2 (1K, 2K, 4K, legfeljebb 14 referenciakép, SynthID), OpenAI GPT Image 2 (2026 április, natív nyelvi modellbe épített generálás), Black Forest Labs Flux.2 (32 milliárd paraméter, nyílt dev súlyok), Midjourney V8.2 (2026 július), Ideogram 4.0 (2026 június, nyílt súlyok, tipográfia), ByteDance Seedream 5.0 Pro (2026 július, 20 rétegre bontás), Stability AI Stable Diffusion 3.5.

Zenei és hanggeneráló AI: technológia és szabályozás

Zenei és hanggeneráló AI: technológia és szabályozás

Kodek-tokenek: a hangból számsor lesz

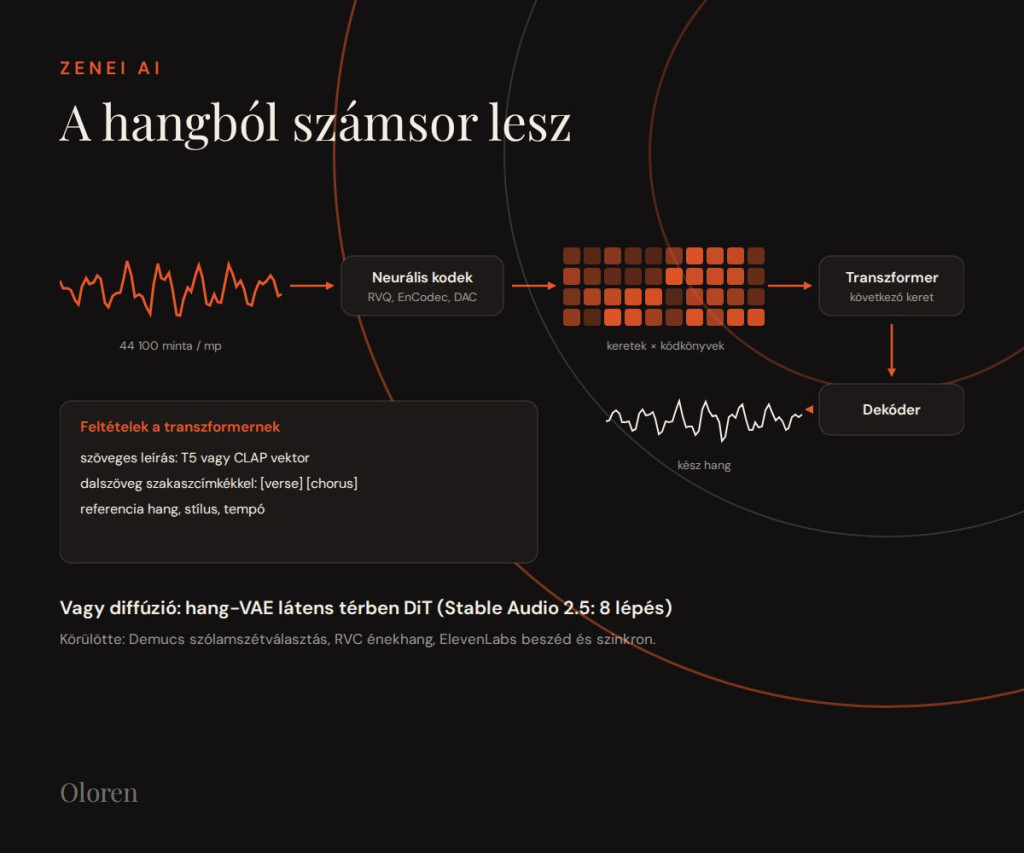
A nyers hang másodpercenként 44 100 mintából áll, ez egy transzformernek túl hosszú. A zenei modellek ezért egy neurális kodekkel (SoundStream, EnCodec, DAC) tömörítik a hullámformát másodpercenként néhány tucat "keretre", és minden keret néhány egész számot kap tanult kódkönyvekből (reziduális vektorkvantálás). Innen két út van. Az autoregresszív modellek (MusicLM, MusicGen, és a nyilvánosan dokumentált dalmodellek, mint a YuE vagy a HeartMuLa) egy nyelvi modellel jósolják a következő hangkeretet, a szöveges leírás T5- vagy CLAP-vektorként, a dalszöveg szakaszcímkékkel ([verse], [chorus]) tokenizálva kerül a bemenetre. A látens diffúziós modellek (AudioLDM, Stable Audio 2.0 és 2.5) egy hang-VAE látens terében futtatnak diffúziós transzformert, a Stable Audio 2.5 nyolc lépésben, két másodperc alatt ad három perces zenét.

A kereskedelmi rendszerek (Suno, Udio) architektúrája nem nyilvános. Köréjük épül a tágabb hang-AI: szólamszétválasztás (Demucs), hangklónozás és énekhang-konverzió (RVC, ElevenLabs), szövegfelolvasás, valamint az AI-szinkron, amely a beszédet lefordítja, a klónozott hangon újraszintetizálja és a szájmozgáshoz igazítja.

Zenei és hanggeneráló AI: technológia és szabályozás

Licencelt vagy lekapart: 2025 és 2026 fordulópontjai

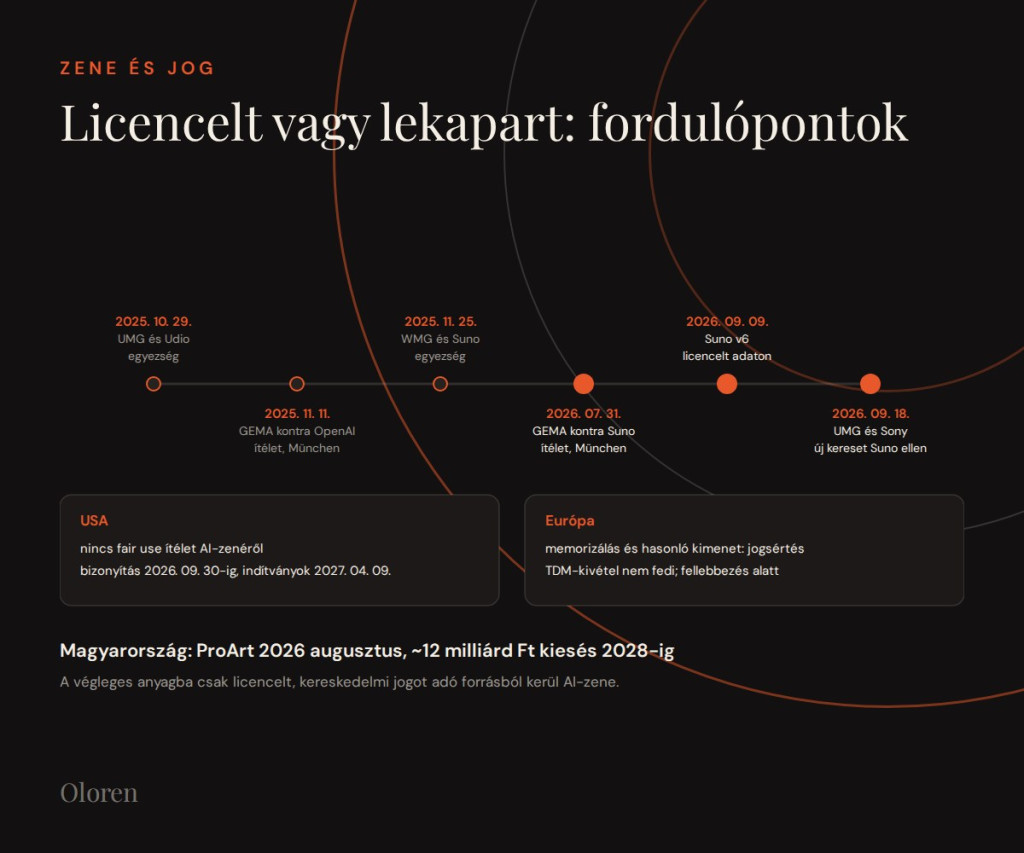
A zenei generatív AI jogi térképe 2026-ban rajzolódott át. A Universal 2025. október 29-én, a Warner 2025. november 19-én egyezett meg az Udióval, a Warner 2025. november 25-én a Sunóval; a Suno 2026. szeptember 9-én adta ki a v6 modellcsaládot, amelyet saját közlése szerint Warner, BMG és Believe licencelt anyagon tanított. Ugyanakkor a Universal és a Sony 2026. szeptember 18-án újabb keresetet adott be a Suno ellen 60 202 hangfelvétel miatt, a Sony 2026. július 20-án az Udio ellen, az amerikai fair use kérdésről pedig nincs még ítélet: a Suno-ügyben a bizonyítási szakasz 2026. szeptember 30-án zárul, az érdemi indítványok határideje 2027. április 9.

Európában más a helyzet. A müncheni tartományi bíróság 2025. november 11-én a GEMA javára döntött az OpenAI ellen (a dalszövegek memorizálása a súlyokban többszörözés, a szöveg- és adatbányászati kivétel nem fedi), majd 2026. július 31-én a Suno ellen is: a tanítás, a memorizálás, a kimenet és a nyilvánossághoz közvetítés egyaránt jogsértő, az amerikai fair use érvet elutasította. Mindkét ügy fellebbezés alatt. Magyarországon a ProArt 2026 augusztusi zeneipari jelentése 2028-ig mintegy 12 milliárd forint kiesést vetít előre a hazai zeneszerzők és előadók jogdíjaiban az AI-zene miatt.

Zenei és hanggeneráló AI: technológia és szabályozás

Platformszabályok 2026: címke, kizárás, tiltás

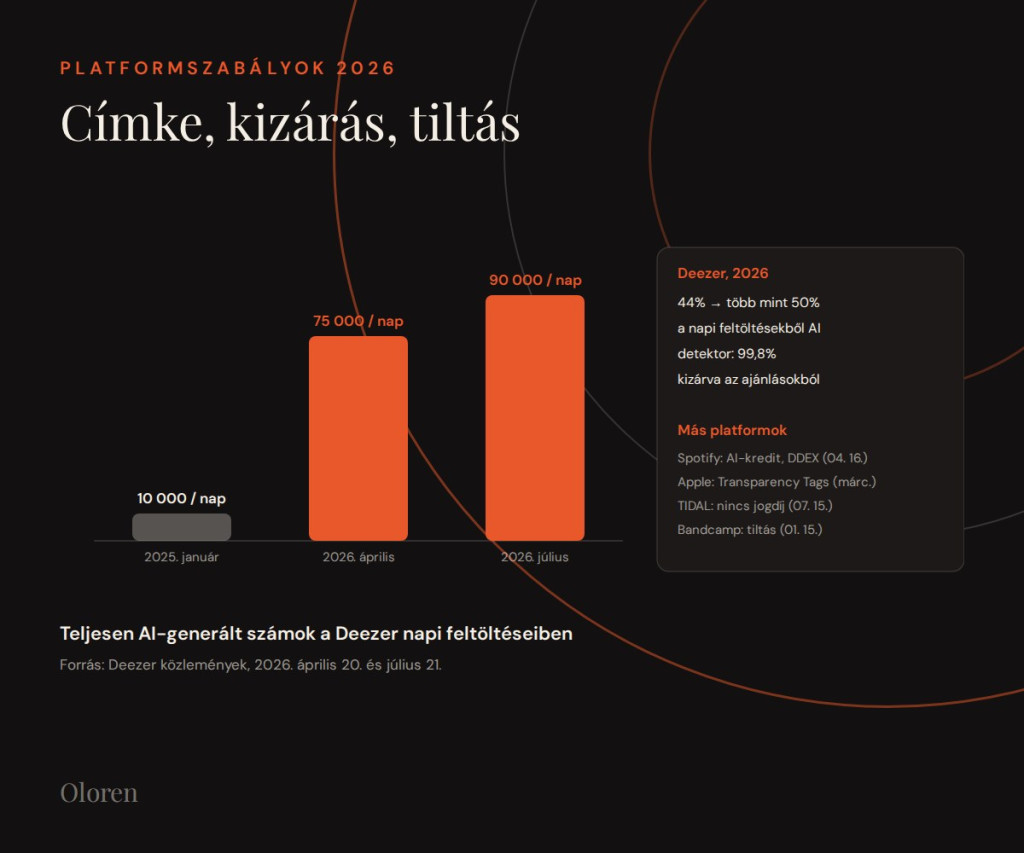
A Deezer 2026. április 20-i közlése szerint a napi feltöltések 44 százaléka (mintegy 75 ezer szám naponta) teljesen AI-generált volt, 2026 júliusában ez átlépte az 50 százalékot (körülbelül 90 ezer szám naponta); a platform az AI-számokat kizárja az algoritmikus és szerkesztett ajánlásokból, a detektora saját közlése szerint 99,8 százalékos pontosságú. A Spotify 2026. április 16-tól DDEX-szabvány szerinti AI-megjelölést mutat a kreditekben, tiltja a jogosulatlan hangklónokat és spamszűrővel dolgozik; az Apple Music 2026 márciusától "Transparency Tags" önbevallást kér; a TIDAL 2026. július 15-től a teljesen AI-generált számokat kizárja a jogdíjelosztásból; a Bandcamp 2026. január 15-től tiltja a teljesen vagy jelentős részben AI-val készült zenét.

Reklám- és tartalomgyártásban a következtetés egyszerű: AI-zene végleges anyagban csak licencelt platformról, kereskedelmi jogot adó csomagból, dokumentált feltételekkel; hangulatreferenciának, ideiglenes zenének (temp track) és hangtervezési vázlatnak viszont a leggyorsabb eszköz. Valódi előadó hangját vagy stílusát nem klónozzuk, ezt a platformok a jelöléstől függetlenül tiltják.

Nyelvi modellek: hogyan működik a ChatGPT, a Gemini és a Claude

Nyelvi modellek: hogyan működik a ChatGPT, a Gemini és a Claude

Tokenizálás: a magyar szó több darabra esik

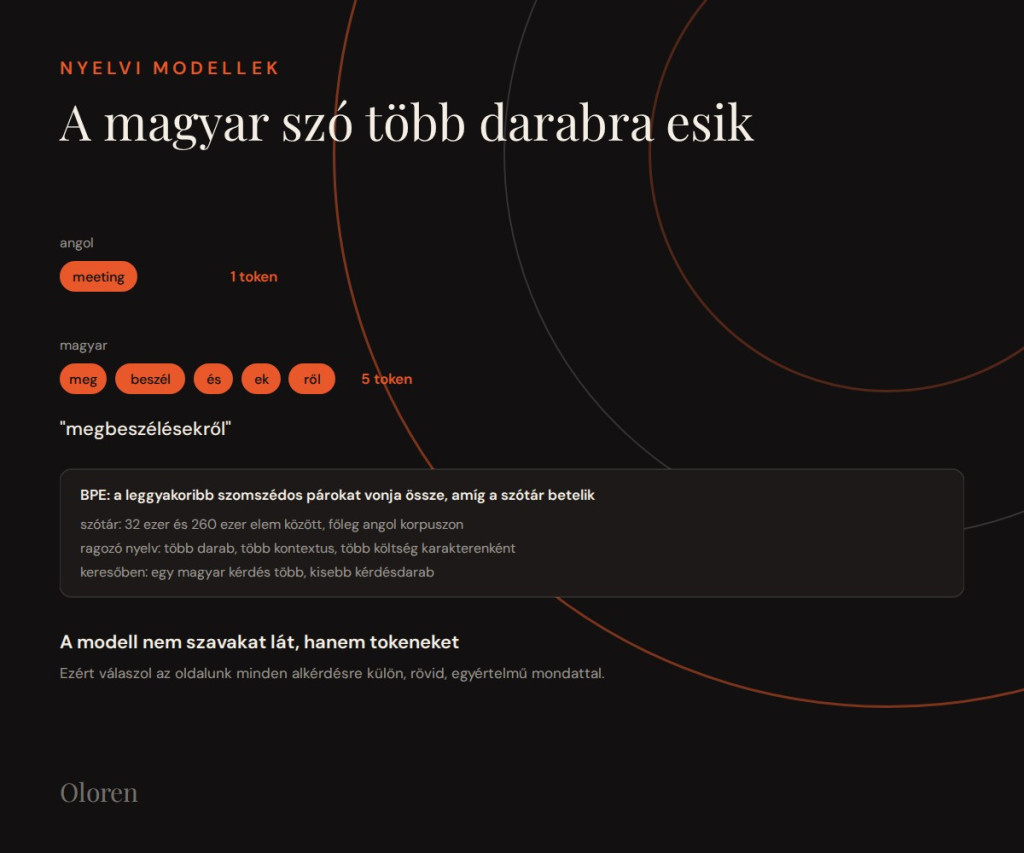
A nyelvi modell nem szavakat, hanem tokeneket lát: egy 32 ezer és 260 ezer közötti elemű szótár darabjait. A byte-pair encoding (BPE) a leggyakoribb szomszédos karakterpárokat vonja össze, amíg a szótár be nem telik; a SentencePiece nyers szövegen tanul, szóköz-előfeldolgozás nélkül. Mivel a szótárak főleg angol korpuszon készülnek, a ragozó magyar nyelv jobban töredezik: egy angol szó jellemzően egy token, a "megbeszélésekről" 3 és 6 közötti token.

Ennek három gyakorlati következménye van. A magyar szöveg több kontextust és több pénzt fogyaszt karakterenként; a modell magyarul valamivel gyengébb, mint angolul; és a keresőmotorokban egy magyar kérdés több tokent, tehát több, kisebb "kérdésdarabot" jelent, amelyekre az oldalunknak külön-külön kell válaszolnia.

Nyelvi modellek: hogyan működik a ChatGPT, a Gemini és a Claude

Figyelem: a transzformer alapművelete

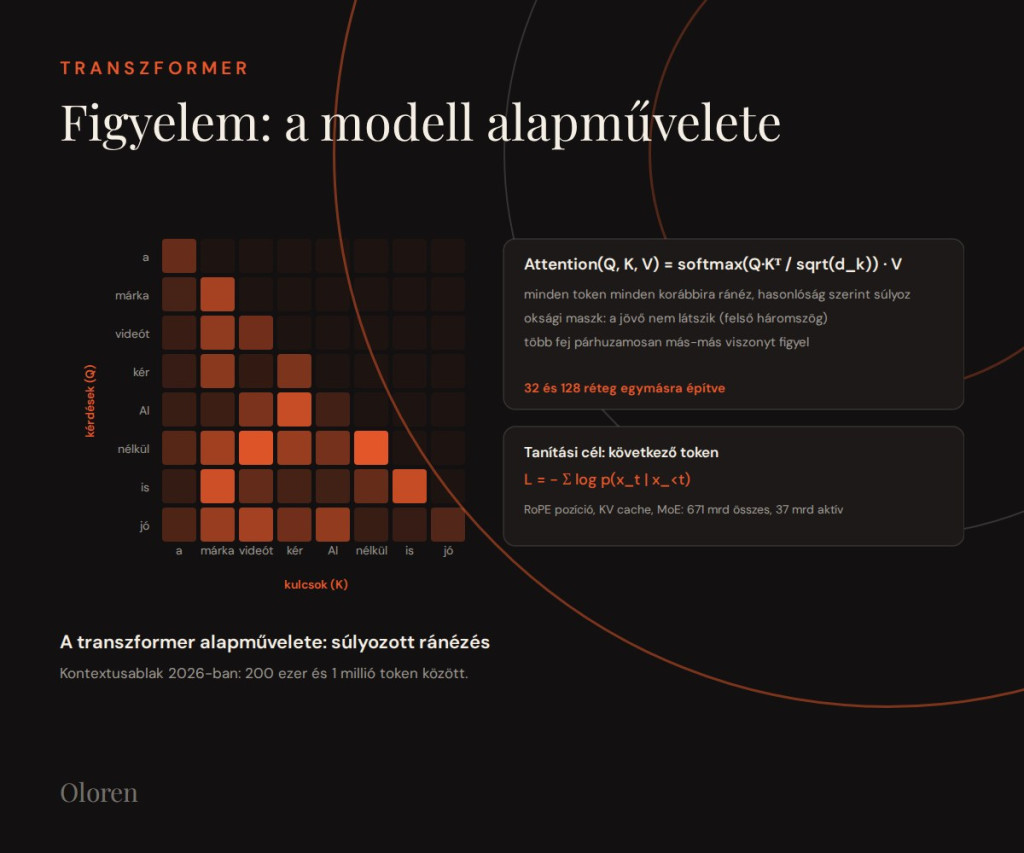
A transzformer (Vaswani és társai, 2017) minden tokenhez három vektort számol: kérdés (Q), kulcs (K), érték (V). A figyelem képlete: Attention(Q, K, V) = softmax(Q·K^T / sqrt(d_k)) · V. Minden token minden korábbi tokenre "ránéz", a hasonlóság alapján súlyozza, és a súlyozott értékek összegét viszi tovább. Dekóder-modellben egy oksági maszk tiltja a jövőbe nézést. Több fej (multi-head) párhuzamosan más-más viszonyt figyel, a blokkot egy előrecsatolt hálózat, reziduális kapcsolat és normalizálás egészíti ki, ebből 32 és 128 közötti réteg épül egymásra.

A pozíciót forgó kódolás (RoPE) adja: a Q és K vektorokat a pozícióval arányos szöggel forgatják, így a skaláris szorzat csak a relatív távolságtól függ. A tanítási cél a következő token keresztentrópiája: L = - sum_t log p(x_t | x_<t). Válaszadáskor a modell tokenenként mintavételez (hőmérséklet, top-p), a korábbi kulcsokat és értékeket gyorsítótárban tartja (KV cache), a kontextusablak 2026-ban 200 ezer és 1 millió token között mozog. A vegyes szakértői (MoE) modellek tokenenként csak néhány "szakértő" alhálózatot aktiválnak, ezért lehet egy 671 milliárd paraméteres modellnek 37 milliárd aktív paramétere.

Nyelvi modellek: hogyan működik a ChatGPT, a Gemini és a Claude

Tanítási lépcsők: előtanítás, finomhangolás, RLHF, érvelés

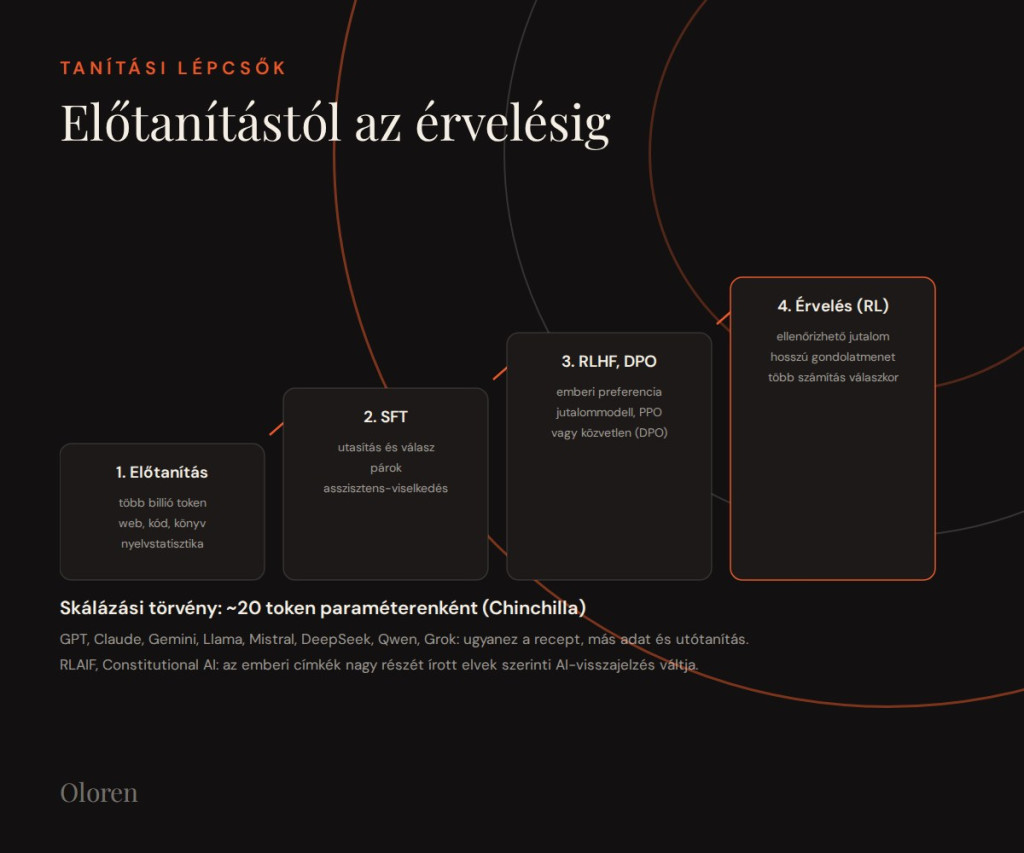
1. Előtanítás több billió token webes szövegen, kódon, könyvön: a modell a nyelv statisztikáját tanulja, még nem "asszisztens". 2. Felügyelt finomhangolás (SFT) utasítás és válasz párokon. 3. RLHF (Ouyang és társai, 2022): emberek rangsorolnak válaszpárokat, ebből jutalommodell készül, és a nyelvi modellt megerősítéses tanulással (PPO) optimalizálják a jutalomra, egy KL-büntetéssel, hogy ne szakadjon el az SFT-modelltől. A DPO (2023) a jutalommodellt kihagyva közvetlenül a preferenciákat tanulja; az RLAIF és a Constitutional AI az emberi címkék nagy részét írott elvek alapján dolgozó AI-visszajelzéssel váltja ki. 4. Érvelő modellek: ellenőrizhető jutalmon (helyes matematikai vagy kódválasz) tanított megerősítéses tanulással a modell hosszú gondolatmeneteket tanul (DeepSeek-R1, 2025), és a válaszidőben több számítást használ.

A skálázási törvények (Kaplan 2020, Chinchilla 2022) szerint a veszteség hatványfüggvény szerint csökken a paraméterek, az adat és a számítás növelésével, és a számításoptimális tanítás paraméterenként nagyjából 20 tokent használ. A 2026-os csúcsmodellek (GPT, Claude, Gemini, Llama, Mistral, DeepSeek, Qwen, Grok családok) mind ezt a receptet követik, a különbség az adatban, a méretben, a többmodalitásban és az utótanításban van.

Nyelvi modellek: hogyan működik a ChatGPT, a Gemini és a Claude

RAG és webkeresés: honnan tudja a modell, mi igaz

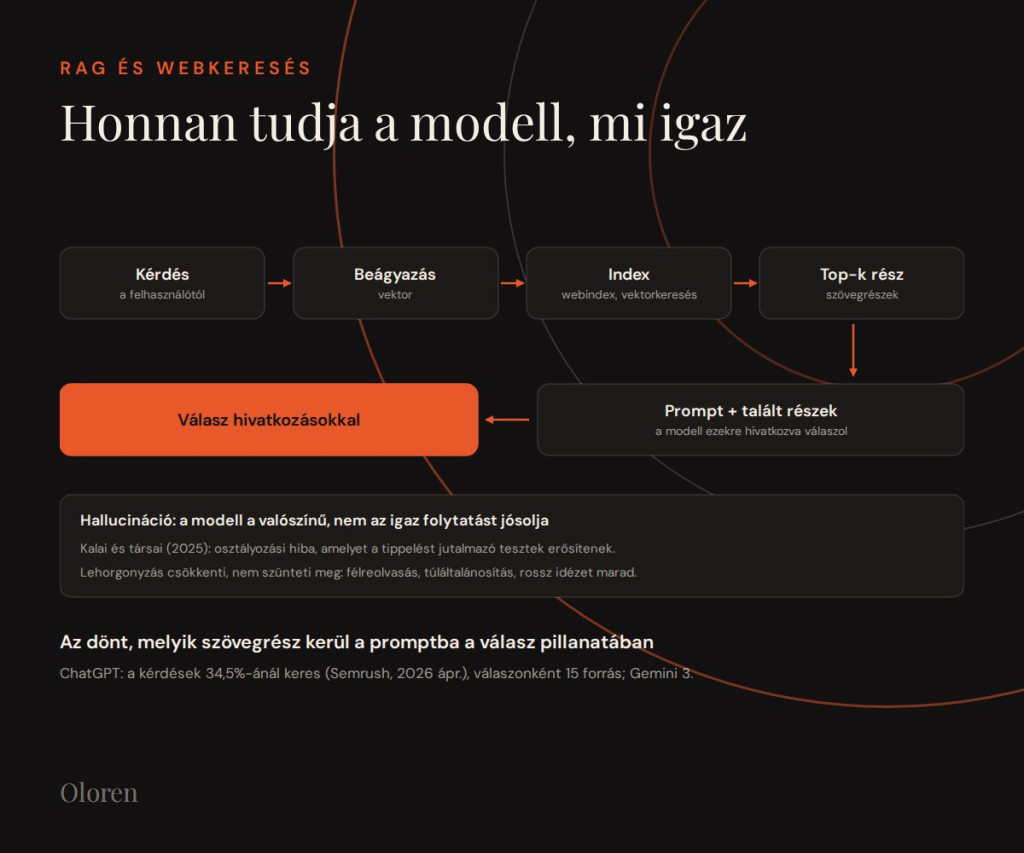
A nyelvi modell a következő valószínű tokent jósolja, nem az igazat: ezért hallucinál. Kalai és társai (OpenAI, 2025) szerint a hallucináció egyszerű osztályozási hibaként keletkezik, és a tesztek erősítik, mert a tippelést jobban jutalmazzák, mint a tartózkodást. A megoldás a lehorgonyzás: a visszakereséssel bővített generálás (RAG, Lewis és társai, 2020) a kérdést vektorrá alakítja, egy indexben a legközelebbi szövegrészeket keresi meg, ezeket a promptba illeszti, és a modell ezekre hivatkozva válaszol. Az AI-keresők (ChatGPT search, Perplexity, Google AI Mode, Gemini, Copilot, Claude, Grok) ugyanez a séma, ahol a visszakereső egy webindex.

Ebből következik a GEO lényege: nem az dönt, mit "tud" a modell, hanem az, melyik szövegrész kerül be a promptba a válasz pillanatában. A Semrush 2026 áprilisi vizsgálata szerint a ChatGPT a kérdések 34,5 százalékánál él webkereséssel, a 2026 júniusi AI Visibility Index szerint válaszonként átlagosan 15 forrást idéz, a Gemini hármat. A modell tud tévedni akkor is, ha jó forrást kapott: félreolvas, túláltalánosít, vagy olyan részletet idéz, amely nem támasztja alá az állítást. Ezért a hivatkozható, egyértelmű, adatolt oldal a legjobb védekezés a téves idézés ellen is.

AI-keresők és GEO: hogyan választ forrást a gép

AI-keresők és GEO: hogyan választ forrást a gép

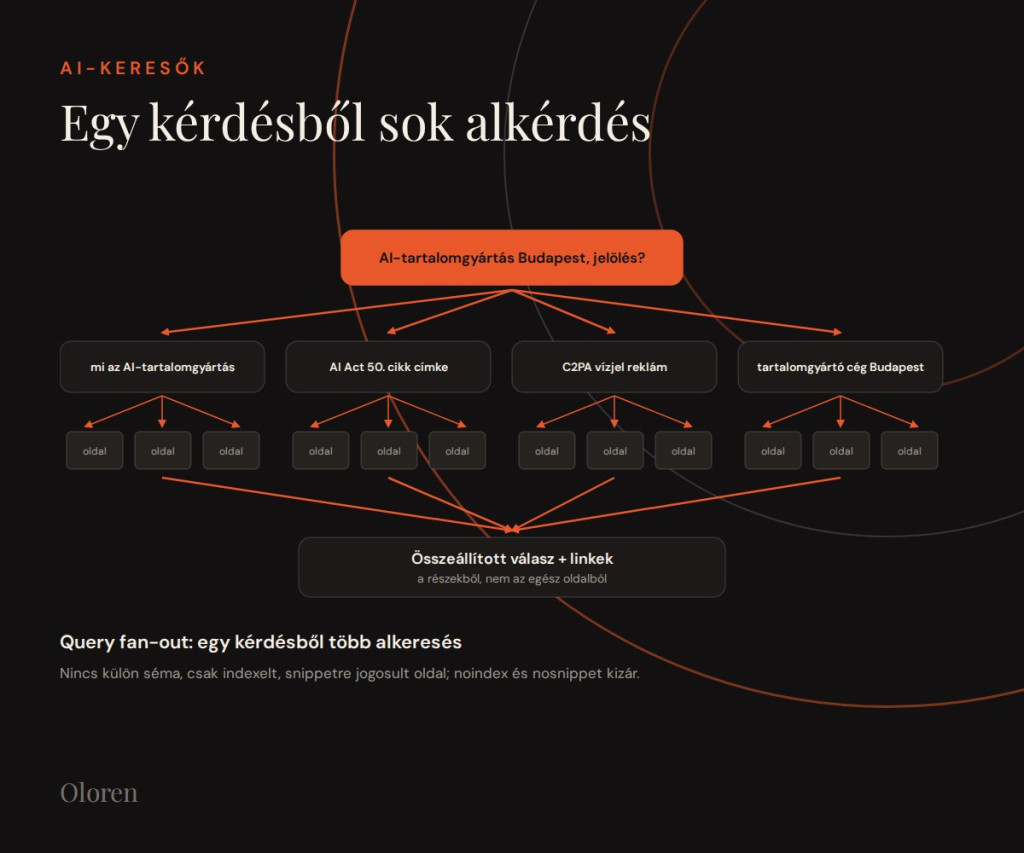
Query fan-out: egy kérdésből sok alkérdés

A Google dokumentációja szerint az AI Overviews és az AI Mode "query fan-out" technikát használ: a felhasználó kérdését több kapcsolódó alkeresésre bontja témák és adatforrások szerint, a Gemini-alapú modell pedig az így talált oldalakból állítja össze és linkeli a választ. Nincs külön technikai követelmény és nincs külön strukturált adat, amit hozzá kellene adni; az oldalnak indexelve és snippetre jogosultnak kell lennie, a nosnippet és a noindex kizár. A Google-Extended robots-szabály csak a Gemini tanítását és lehorgonyzását érinti, az AI Overviews-t és az AI Mode-ot nem.

A gyakorlati következmény: az oldal nem egy fő kulcsszóra, hanem alkérdésekre versenyez. A ChatGPT keresést indító promptjai átlagosan 8,7 szavasak (Semrush, 2026 április), a klasszikus 2 és 4 szó közötti kulcsszó helyett beszélt nyelvű, több szándékú kérdések. Ezért írunk minden H2 és H3 alá az első egy-két mondatban közvetlen választ, és ezért kap minden állítás megnevezett forrást és dátumot.

AI-keresők és GEO: hogyan választ forrást a gép

Mitől idézhető egy oldal 2026-ban

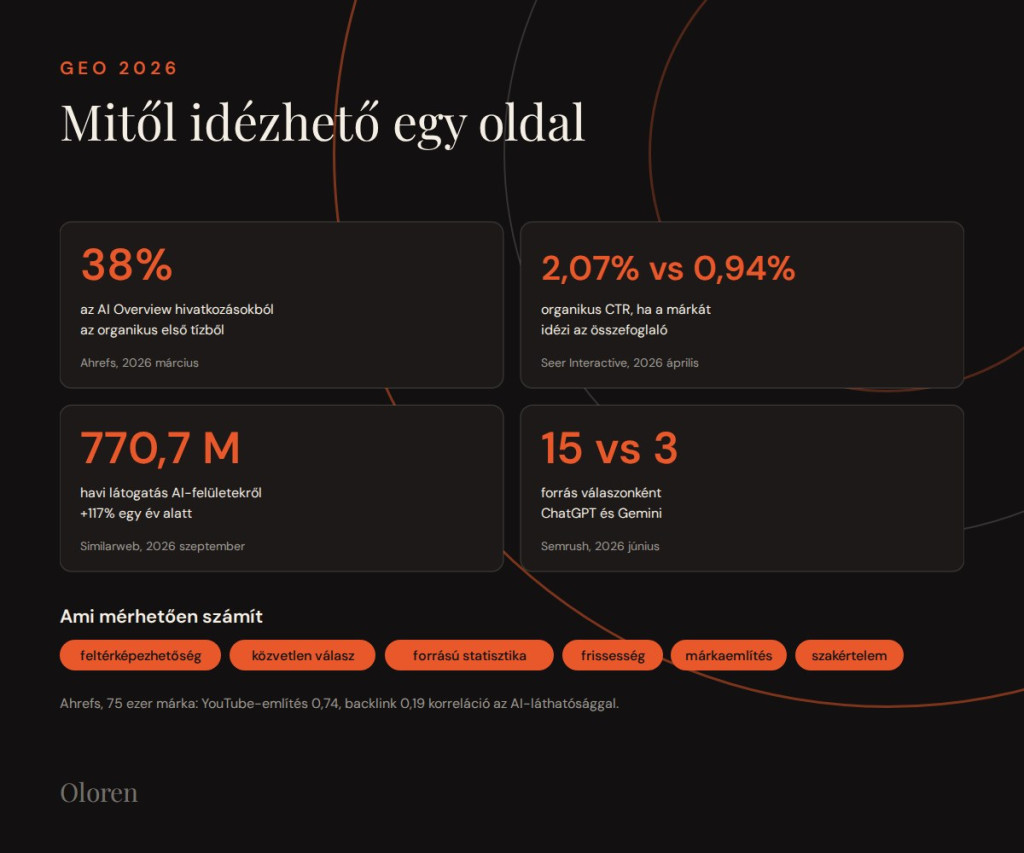
Az Ahrefs 2026 márciusi vizsgálata (863 ezer kulcsszó, 4 millió AI Overview hivatkozás) szerint az idézett oldalak 38 százaléka áll az organikus első tízben, 31 százaléka a százon túl, a YouTube pedig az összes hivatkozás 5,6 százalékát adja. A Seer Interactive 2026 áprilisi mérése (53 márka, 5,47 millió lekérdezés) szerint AI Overview mellett az organikus átkattintás 2,36 százalék a 3,82 helyett, de ha a márkát az összefoglaló idézi, az információs kérdéseknél 2,07 százalék a 0,94 helyett, vagyis több mint duplája. A Similarweb 2026 szeptemberi adata szerint az AI-felületek havi átlagban 770,7 millió látogatást irányítottak weboldalakra, egy év alatt 117,4 százalékos növekedéssel; a generatív AI forgalmából 2026 májusában a ChatGPT 52,7, a Gemini 27,3, a Claude 8,9 százalékot vitt.

Ami mérhetően számít: feltérképezhetőség az AI-robotok számára (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer); közvetlen válasz minden címsor alatt; megnevezett forrású statisztika, idézet és hivatkozás (a Princeton GEO-tanulmány szerint 30 és 40 százalék közötti láthatóságnövekedés, a kulcsszóhalmozás semmi); frissesség látható dátummal; márkaemlítések a weben, YouTube-on és Redditen (az Ahrefs 75 ezer márkás korrelációjában a YouTube-említés 0,74, a backlinkszám 0,19); szerzői szakértelem és saját kutatás. A schema.org és az oldalsebesség az indexelést segíti, közvetlen idézési hatását 2026-os vizsgálat nem mutatta ki. Ezt mérjük az Ahrefs Brand Radarral: AI-említés, hivatkozás, becsült megjelenés és share of voice a ChatGPT, Google AI Overviews, AI Mode, Gemini, Perplexity, Copilot, Claude és Grok felületeken. Részletesen a SEO, GEO és AEO és a GEO-optimalizálás oldalon.
Jelölés és eredetigazolás: C2PA, SynthID, platformcímkék

Jelölés és eredetigazolás: C2PA, SynthID, platformcímkék

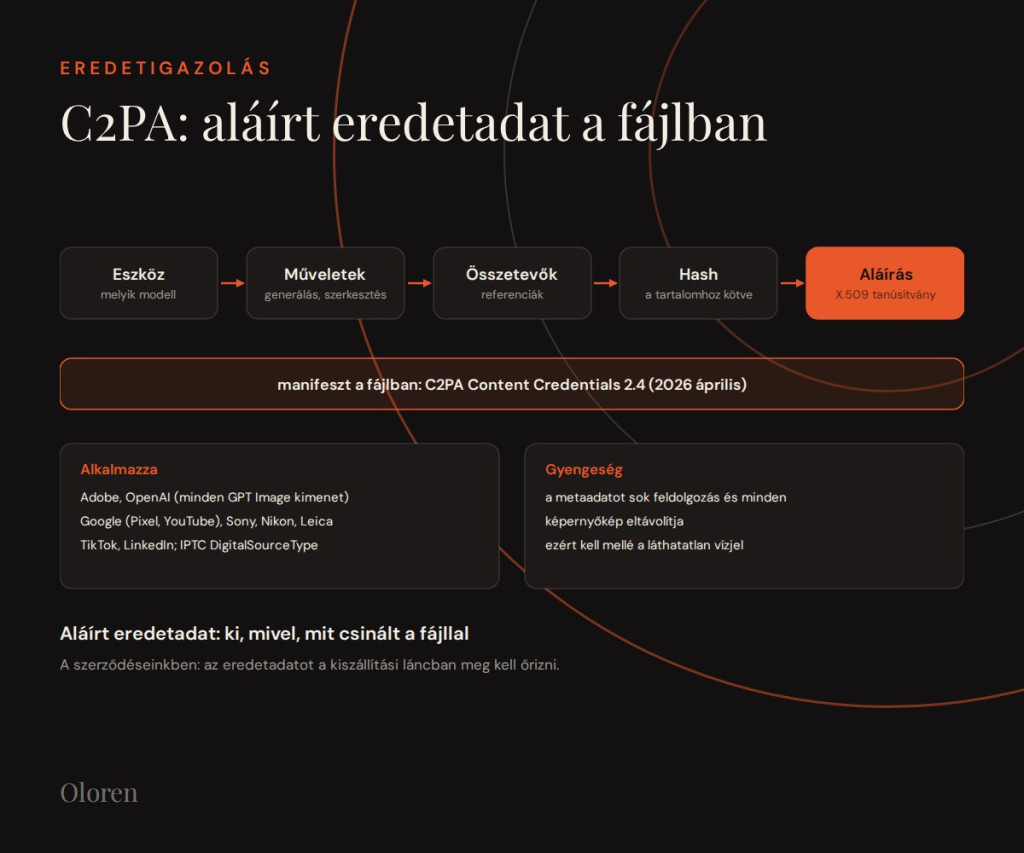
C2PA: aláírt eredetadat a fájlban

A C2PA Content Credentials egy kriptográfiailag aláírt manifeszt a fájlban: rögzíti az eszközt, a műveleteket és az összetevőket, a tartalomhoz hash-sel kötve, X.509 tanúsítvánnyal aláírva. A szabvány 2.4-es verziója 2026 áprilisában jelent meg; alkalmazza az Adobe, az OpenAI (minden GPT Image kimenet), a Google (Pixel, YouTube), a Sony, a Nikon, a Leica, a TikTok és a LinkedIn. Az IPTC metaadatban a DigitalSourceType mező "trainedAlgorithmicMedia" (generatív AI-val készült) és "compositeWithTrainedAlgorithmicMedia" (generatív AI-val szerkesztett) értéke ugyanezt jelzi, ezt olvassa a Google "About this image" és a Meta.

A gyengesége, hogy a metaadatot sok feldolgozási lánc és minden képernyőkép eltávolítja. Ezért párosítja az EU-s gyakorlati kódex a láthatatlan vízjellel, és ezért írjuk elő a szerződéseinkben, hogy az eredetadatot a kiszállítási láncban meg kell őrizni.

Jelölés és eredetigazolás: C2PA, SynthID, platformcímkék

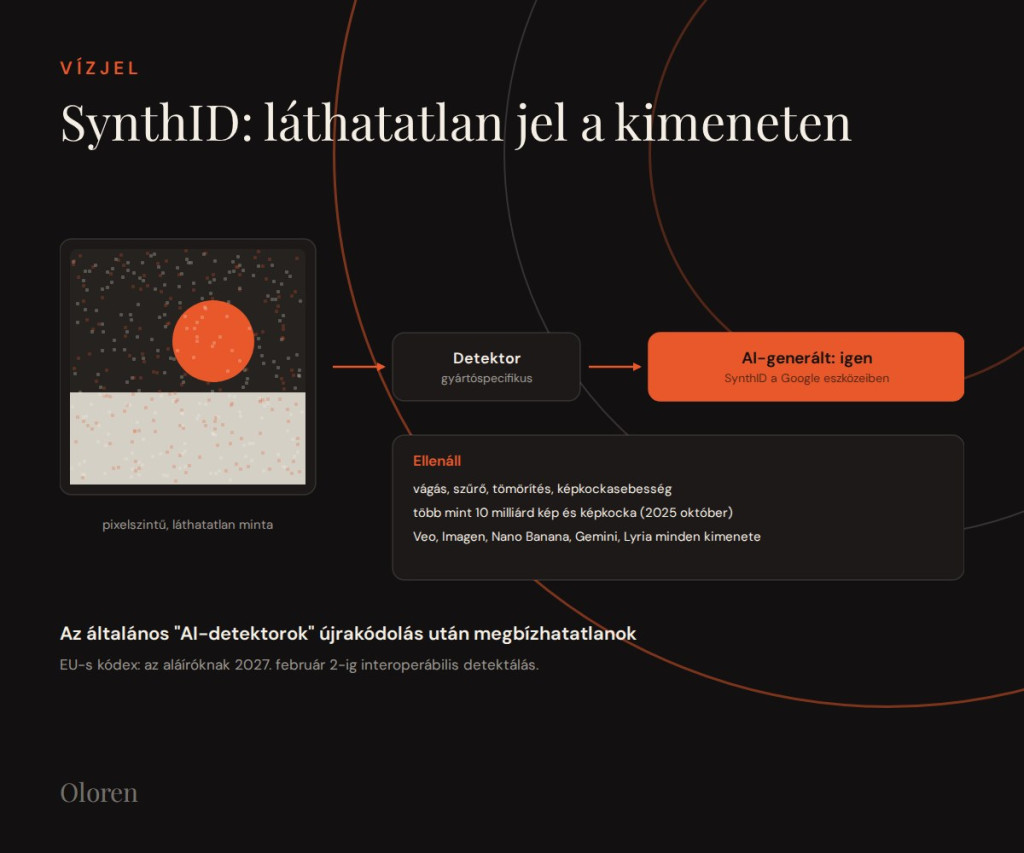
SynthID: láthatatlan vízjel

A Google SynthID a generálás pillanatában pixelszintű, szemmel láthatatlan vízjelet ágyaz a képbe, videóba, hangba és szövegbe, amely ellenáll a vágásnak, a szűrőknek, a tömörítésnek és a képkockasebesség változtatásának. A 2025 októberi SynthID-Image tanulmány szerint több mint 10 milliárd kép és képkocka kapott ilyen jelet; a Veo, az Imagen, a Nano Banana, a Gemini és a Lyria minden kimenete vízjeles, a Gemini alkalmazás pedig ellenőrizni tudja. A detektorok gyártóspecifikusak: a SynthID-t a Google eszköze, az OpenAI kimenetét az OpenAI osztályozója ismeri fel; az általános "AI-detektorok" tanult műtermékekre építenek, és újrakódolás után megbízhatatlanok. Az EU-s kódex aláíróinak 2027. február 2-ig kell interoperábilis detektálást biztosítaniuk.

Jelölés és eredetigazolás: C2PA, SynthID, platformcímkék

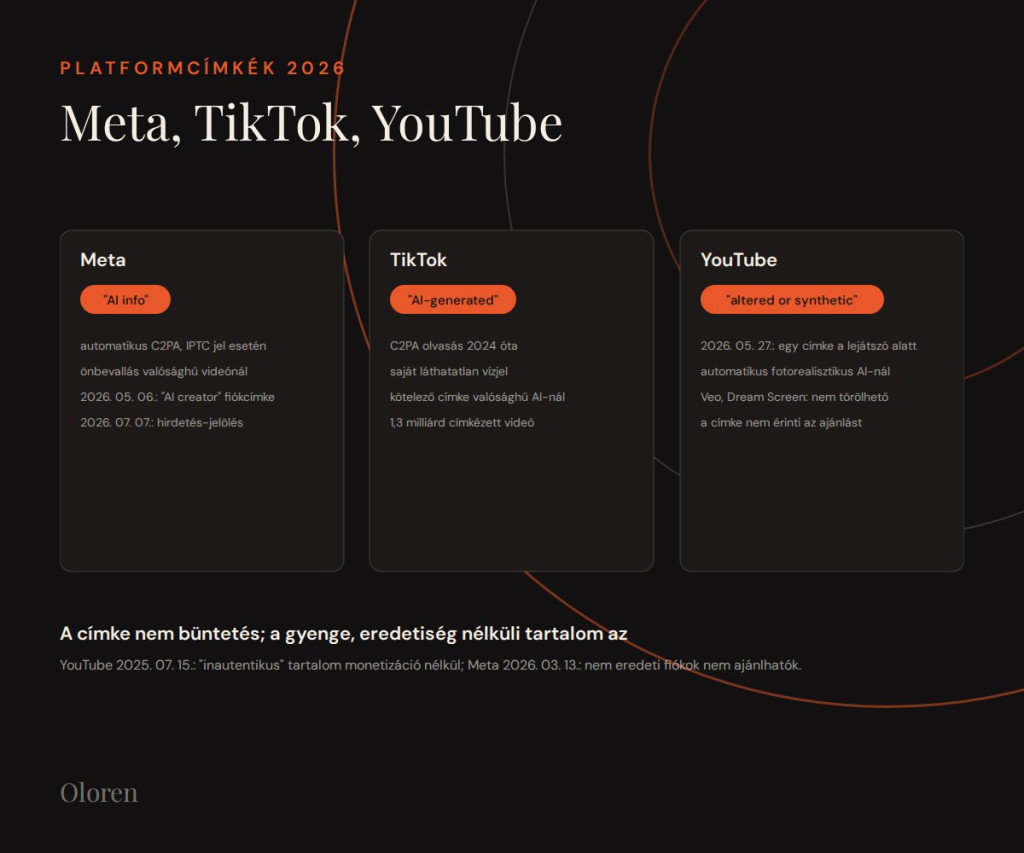
Platformcímkék 2026

Meta (Facebook, Instagram, Threads): automatikus "AI info" címke C2PA vagy IPTC jel esetén, kötelező önbevallás valósághű AI-videónál és -hangnál; 2026. május 6-tól önkéntes, fiókszintű "AI creator" jelölés az Instagramon elérésbüntetés nélkül; 2026. július 7-től a hirdetéseknél az "About this ad" mutatja, ha a kreatív Meta- vagy külső generatív eszközzel készült vagy módosult. TikTok: 2024 óta olvassa a C2PA-t, saját láthatatlan vízjelet tesz az AI-tartalomra, kötelező címke valósághű AI-képnél és -hangnál, több mint 1,3 milliárd videót címkézett. YouTube: 2026. május 27-től egyetlen "altered or synthetic content" címke a lejátszó alatt (Shorts-nál rávetítve), automatikus címkézés fotorealisztikus AI-tartalomnál vagy C2PA-adatnál; a Veo- és Dream Screen-tartalmak címkéje nem távolítható el; a címke önmagában nem befolyásolja az ajánlást és a bevételt.

Ami viszont igen: a YouTube 2025. július 15-től az "inautentikus", tömeggyártott tartalmat zárja ki a monetizációból, a Meta 2026. március 13-tól a főleg nem eredeti tartalmat közlő fiókokat teszi nem ajánlhatóvá. A címke tehát nem büntetés, a gyenge minőségű, eredetiség nélküli AI-tartalom az.

Jogi szabályozás 2026-ban: EU, Magyarország, világ

Jogi szabályozás 2026-ban: EU, Magyarország, világ

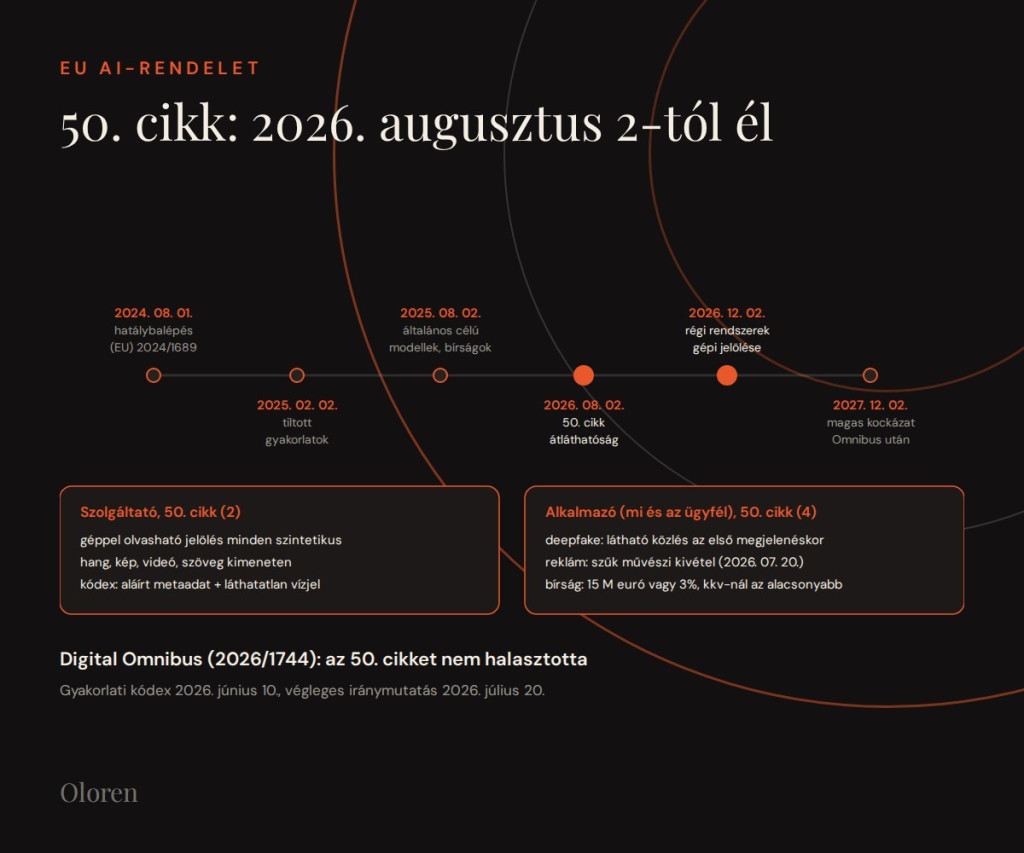
EU AI-rendelet, 50. cikk: 2026. augusztus 2-tól él

Az (EU) 2024/1689 rendelet (AI Act) 2024. augusztus 1-jén lépett hatályba; a tiltott gyakorlatok 2025. február 2-tól, az általános célú modellek kötelezettségei 2025. augusztus 2-tól, az 50. cikk átláthatósági kötelezettségei 2026. augusztus 2-tól alkalmazandók. A 2026. július 27-én hatályba lépett Digital Omnibus ((EU) 2026/1744 rendelet) az 50. cikket nem halasztotta el, csak a 2026. augusztus 2. előtt már piacon lévő generatív rendszerek gépi jelölésére adott türelmi időt 2026. december 2-ig, a magas kockázatú rendszerek határidejét 2027. december 2-ra, illetve 2028. augusztus 2-ra tolta, és 2026. december 2-tól tiltja a "levetkőztető" és a gyermekekkel visszaélő képgeneráló rendszereket.

Az 50. cikk (2) bekezdése a szolgáltatóra ró kötelezettséget: a szintetikus hang, kép, videó és szöveg kimenetet géppel olvasható formában kell megjelölni és felismerhetővé tenni. A (4) bekezdés az alkalmazóra, tehát ránk és az ügyfeleinkre: aki deepfake-et (létező személyre, tárgyra, helyre, eseményre hasonlító, hitelesnek látszó tartalmat) hoz létre vagy módosít, köteles közölni, hogy az mesterségesen készült; a művészi, szatirikus, fikciós műveknél a közlés a mű élvezetét nem zavaró módon is elég. A Bizottság 2026. június 10-én közzétett gyakorlati kódexe a szolgáltatóktól legalább két gépi technikát vár (aláírt C2PA-típusú metaadat és láthatatlan vízjel), az alkalmazóktól az első megjelenéskor látható, egységes uniós ikont vagy "AI-generált", "AI-módosított" feliratot. A 2026. július 20-i végleges iránymutatás a reklámot szűken kezeli: a kizárólag tájékoztató vagy kereskedelmi tartalom nem élhet a művészi kivétellel, és a terméket a valóságtól eltérően mutató AI-reklám deepfake-címkét igényel. A bírság az 50. cikk megsértéséért legfeljebb 15 millió euró vagy a globális forgalom 3 százaléka, kkv-nál a kettő közül az alacsonyabb.

Jogi szabályozás 2026-ban: EU, Magyarország, világ

Szerzői jog: ki a szerző, és mi védett?

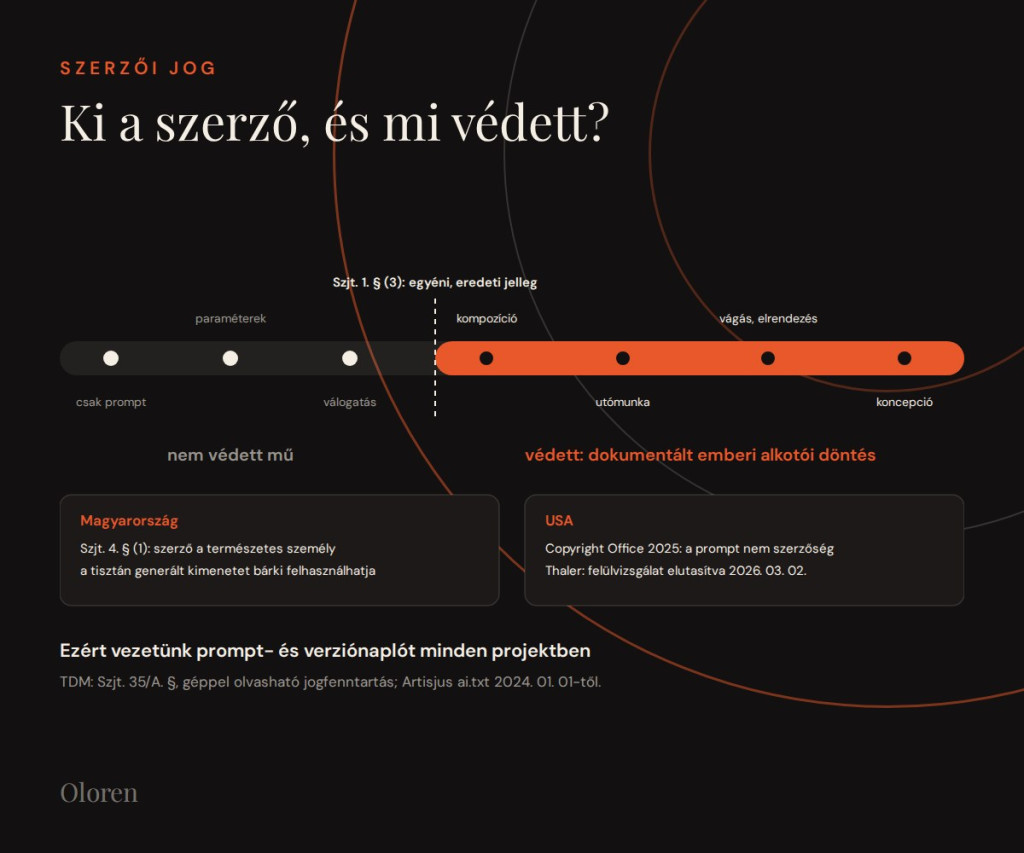
A magyar Szjt. (1999. évi LXXVI. törvény) 1. § (3) bekezdése szerint a védelemhez a szerző szellemi tevékenységéből fakadó egyéni, eredeti jelleg kell, a 4. § (1) szerint szerző az, aki a művet megalkotta, vagyis természetes személy. A tisztán géppel generált kimenet így nem védett mű: azt bárki, a versenytárs is szabadon felhasználhatja. Az Egyesült Államokban ugyanez a szabály: a Copyright Office 2025 januári jelentése szerint a prompt önmagában nem alapoz meg szerzőséget, a Thaler-ügyben pedig a Legfelsőbb Bíróság 2026. március 2-án elutasította a felülvizsgálatot, tehát az emberi szerzőség követelménye végleges.

Ami védetté teszi az eredményt, az a dokumentált emberi alkotói döntés: koncepció, kompozíció, iteratív irányítás, válogatás, utómunka, vágás, elrendezés. Ezért vezetünk minden AI-projektben prompt- és verziónaplót, és ezért kerül a kész anyagba mindig emberi alkotói réteg. Az EU-ban a 2019/790 irányelv 4. cikke (Szjt. 35/A. §) a szöveg- és adatbányászatot engedi, kivéve ha a jogosult géppel olvasható módon fenntartotta a jogait; az Artisjus 2024. január 1-jétől kollektív fenntartást tett ai.txt fájllal. Az Európai Parlament 2026. március 10-én fogadta el a Voss-jelentést (díjazás, átláthatóság, megdönthető vélelem a felhasználásról), a Bizottság 2026. május 13-án indított konzultációt, az Európai Bíróság előtt pedig magyar előterjesztésre fut az első generatív AI-s szerzői jogi ügy (Like Company kontra Google, C-250/25, tárgyalás 2026. március 10.).

Jogi szabályozás 2026-ban: EU, Magyarország, világ

Magyar hatóság, személyiségi jog, adatvédelem

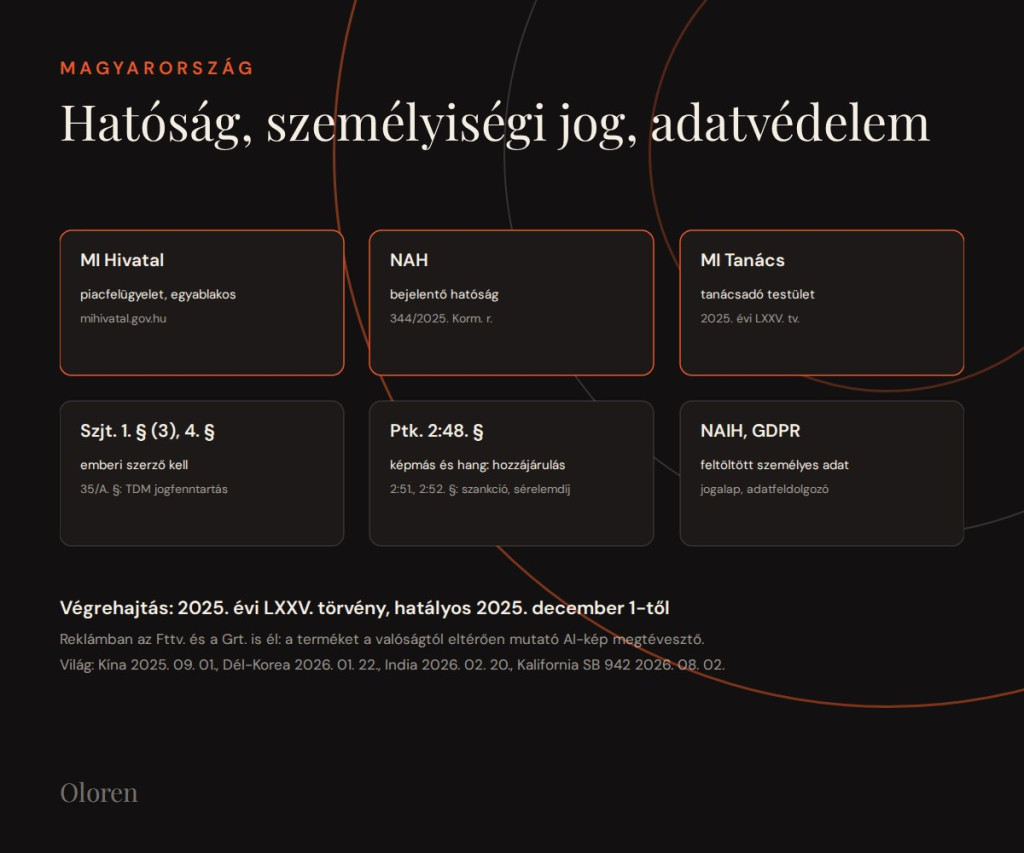
A 2025. évi LXXV. törvény (hatályos 2025. december 1-től) és a 344/2025. (X. 31.) Korm. rendelet hajtja végre az AI-rendeletet: a bejelentő hatóság a Nemzeti Akkreditáló Hatóság, a piacfelügyeleti hatóság és egyben egyablakos kapcsolattartó a Mesterséges Intelligencia Hivatal (mihivatal.gov.hu), amely a szabályozói tesztkörnyezetet is működteti; mellette a Magyar Mesterséges Intelligencia Tanács ad tanácsot. A hivatal tájékoztatója szerint a szolgáltatónak legkésőbb az első interakciónál szöveges, vizuális vagy hangalapú értesítést kell adnia az AI használatáról, és a kimenetet géppel olvasható formában kell megjelölnie.

A képmás és a hang a Ptk. 2:48. § (1) alapján hozzájáruláshoz kötött, a jogsértés objektív szankciókkal (2:51. §) és sérelemdíjjal (2:52. §) jár. Aki ügyfélfotót, felismerhető személyt tölt fel egy generátorba, személyes adatot kezel: ehhez GDPR-jogalap és adatfeldolgozói feltétel kell, a NAIH már 2022-ben 250 millió forintos bírságot szabott ki AI-alapú hangelemzésért. A reklámban az Fttv. és a Grt. általános szabályai élnek: a terméket a valóságtól eltérően mutató AI-kép megtévesztő, akkor is, ha címkézve van. A világ többi részén ugyanez az irány: Kína 2025. szeptember 1-től explicit és implicit címkét ír elő, Dél-Korea 2026. január 22-től, India 2026. február 20-tól; az Egyesült Államokban a TAKE IT DOWN Act 2026. május 19-től 48 órás eltávolítást követel a platformoktól, Kalifornia SB 942 törvénye 2026. augusztus 2-tól metaadat-jelölést, a NO FAKES Act 2026 júniusában jutott át a szenátusi igazságügyi bizottságon.

A 2025 és 2026 közötti bírósági ügyek, amelyek a gyakorlatot alakítják

A minta világos: az Egyesült Államokban a jogszerűen beszerzett anyagon való tanítás eddig fair use-nak minősült, a kalózforrás nem; Európában a memorizálás és a hasonló kimenet jogsértés, a tanítás jogszerűsége forrásfüggő. Reklámgyártásban ezért a kimenet felől gondolkodunk: nem generálunk felismerhető védett művet, karaktert, előadói hangot, és licencelt adaton tanított, vállalati feltételekkel és jogszavatossággal működő eszközöket választunk, ahol ez elérhető.

Szószedet

AI tartalomgyártás szolgáltatásunk

Gyakori kérdések a generatív AI-ról

Tárolja a modell a tanítóképeket?

Nem. A tanítás a hálózat súlyait állítja be, a kész modell mérete töredéke az adathalmaznak, és generáláskor véletlen zajból indul. Memorizálás ritkán, főleg sokszor ismétlődő képeknél fordul elő; ezt deduplikációval és kimeneti szűréssel kezelik a laborok, jogilag pedig ez áll a 2025 és 2026 közötti európai ítéletek középpontjában.

Védett-e szerzői jogilag egy AI-val generált kép?

A tisztán generált kimenet sem a magyar Szjt., sem az amerikai jog szerint nem védett mű, mert nincs emberi szerzője. Ami védett, az a dokumentált emberi alkotói réteg: koncepció, kompozíció, válogatás, utómunka, elrendezés.

Mikor kell címkézni az AI-tartalmat?

Az EU AI-rendelet 50. cikke 2026. augusztus 2-tól alkalmazandó. A szolgáltatónak géppel olvasható jelölést kell adnia a kimenetre, az alkalmazónak látható közlést, ha a tartalom létező személyre, tárgyra, helyre vagy eseményre hasonlít és hitelesnek látszik. A Bizottság iránymutatása szerint a reklám ritkán élhet a művészi kivétellel.

Miben más a flow matching a diffúziónál?

A diffúzió görbe zajütemterv mentén, sok lépésben tanulja a zaj eltávolítását; a flow matching egyenes pályát húz a zaj és a kép közé, és a pálya sebességét tanulja. Az egyenes pálya miatt kevesebb lépés is jó mintát ad; a 2025 és 2026 közötti kép- és videómodellek többsége ezt használja diffúziós transzformerrel.

Hogyan választ forrást a ChatGPT vagy a Google AI Mode?

A kérdést több alkérdésre bontja (query fan-out), az indexből szövegrészeket keres, és ezekre hivatkozva állítja össze a választ. Ezért a közvetlen válaszokat adó, megnevezett forrású, friss és jól feltérképezhető oldalak kerülnek be; a Semrush 2026-os mérése szerint a ChatGPT válaszonként átlagosan 15 forrást idéz, a Gemini hármat.

Miben segíthetünk?

Telefon: +36 (30) 964-0339

E-mail: info@oloren.hu

Érdeklődés tárgya

  1. kérem válasszon
  2. Szolgáltatások
  3. Csomagok
  4. Egyéb kérdés
  1. kérem válasszon
  2. Film & Reels
  3. Fotózás
  4. Marketing
  5. Szövegírás
  6. Arculattervezés
  7. Webfejlesztés
  8. PLÚTÓ CSOMAG
  9. VÉNUSZ CSOMAG
  10. OLOREN CSOMAG
  11. Landing page készítés
  12. Weboldal készítése több aloldallal
  13. Webshop készítés
  14. TikTok hirdetéskezelés
  15. Google Ads hirdetéskezelés
  16. Meta hirdetéskezelés
  17. All-In hirdetéskezelés
  18. TikTok video gyártás
  19. Instagram és Facebook tartalomgyártás
  20. LinkedIn tartalomgyártás
  21. All-In tartalomgyártás
  22. Instagram és Facebook tartalomgyártás
  23. All-In tartalomgyártás
  24. TikTok video gyártás
  25. Instagram és Facebook tartalomgyártás
  26. LinkedIn tartalomgyártás
  27. All-In tartalomgyártás
  28. TikTok video gyártás
  29. All-In tartalomgyártás
  30. LinkedIn tartalomgyártás
  31. All-In tartalomgyártás
  32. YouTube reklámvideó
  33. Google Ads hirdetéskezelés
  34. Imázsfilm
  35. Imázsfilm verziókkal
  36. 2D magyarázó animáció
  37. 3D termékanimáció
  38. Aftermovie
  39. Teljes eseménydokumentáció
  40. Toborzófilm
  41. Employer branding kampány
  42. Webshop készítés
  43. Weboldal készítése több aloldallal
  44. Landing page készítés
  45. Webes alkalmazás
  46. Integráció és adatrendszer
  47. Foglalórendszer
  48. Foglalórendszer CRM-mel
  49. Lead-kezelő CRM
  50. CRM offline konverzióval
  51. Karbantartás
  52. Karbantartás méréssel és tartalommal
  53. Google Ads hirdetéskezelés
  54. All-In hirdetéskezelés
  55. Meta hirdetéskezelés
  56. All-In hirdetéskezelés
  57. TikTok hirdetéskezelés
  58. TikTok video gyártás
  59. All-In hirdetéskezelés
  60. LinkedIn hirdetéskezelés
  61. LinkedIn tartalomgyártás
  62. Instagram és Facebook tartalomgyártás
  63. Meta hirdetéskezelés
  64. All-In tartalomgyártás
  65. Szerveroldali mérés beállítása
  66. Mérés havi ellenőrzéssel
  67. E-mail sorozatok beállítása
  68. Havi hírlevél
  69. PLÚTÓ CSOMAG
  70. VÉNUSZ CSOMAG
  71. OLOREN CSOMAG
  72. Technikai SEO audit
  73. Havi SEO és GEO
  74. Technikai SEO audit
  75. Audit és javítás
  76. Lokális SEO beállítás
  77. Havi lokális SEO
  78. Logótervezés
  79. Logó és arculat
  80. Márkastratégia
  81. Márkastratégia és arculat
  82. Packshot
  83. Packshot és hangulatkép
  84. Portré stúdióban
  85. Csapatfotó helyszínen
  86. Étlapfotózás
  87. Étlap, social és videó
  88. Ingatlanfotó
  89. Ingatlanfotó drónnal
  90. Rendezvényfotózás
  91. Fotó és videó
  92. SEO-szöveg oldalanként
  93. Havi SEO szövegírás
  94. Weboldal szöveg
  95. Többnyelvű weboldal szöveg
  96. GA4 és GTM mérés
  97. Szerveroldali mérés
  98. GEO felmérés
  99. Havi GEO
  100. Online reklámfilm
  101. TV-spot adáskész leadással
  102. YouTube-videó és Shorts, egyedi csomag
  103. All-In tartalomgyártás
  104. Videóklip
  105. Videóklip HDR-rel és VFX-szel

Kérjük adja meg a személyes adatait!

Név*

E-mail*

Telefon*

Megjegyzés

Hozzájárulás az adatkezeléshez* Elfogadom, hogy ezen űrlapon szereplő adataimat a kapcsolatfelvétel érdekében összegyűjtjük és feldolgozzuk. Kérése feldolgozását követően az adatokat töröljük. A felhasználói adatok kezelésével kapcsolatos részletes információk az adatkezelési tájékoztatónkban találhatóak. Adatkezelési tájékoztatónkat itt tekintheti meg.

Küldés
Kedves Látogató!

Köszönjük, hogy üzenetet küldtél nekünk! Munkatársunk hamarosan felveszi veled a kapcsolatot!

↓