Generatives KI-Lexikon 2026: Bild, Video, Musik, Sprachmodelle und das Recht
Wie Bild-, Video-, Musik- und Sprachmodelle funktionieren, womit sie trainiert werden, wie ihre Ausgaben gekennzeichnet werden und was die europäische und ungarische Regulierung 2026 vorschreibt. Ein Fachlexikon mit Algorithmen, Abbildungen und Daten aus 2026.
Worum geht es in diesem Lexikon?
Generative künstliche Intelligenz ist bis 2026 zum alltäglichen Werkzeug der Content-Produktion geworden, das Wissen darüber ist jedoch verstreut: technische Beschreibungen in englischen Fachartikeln, rechtliche Regeln in Verordnungen und Urteilen, Plattformregeln auf Hilfeseiten. Dieser Artikel bündelt an einem Ort, was ein Auftraggeber, Marketer oder Kreativer wissen sollte: wie Bild-, Video-, Musik- und Sprachmodelle funktionieren (mit Algorithmen), womit sie trainiert werden und wie die Daten gelabelt werden, wie die Ausgabe gekennzeichnet wird, was die EU-KI-Verordnung ab dem 2. August 2026 vorschreibt, wo die ungarische Regulierung und Rechtsprechung stehen und wie eine KI-Suche ihre Quellen auswählt.
Die Statistiken und Marktdaten stammen ausschließlich aus Quellen von 2026, bei den Grundalgorithmen sind Name und Jahr der klassischen Studien angegeben. Wie all das in unserer eigenen Produktionspraxis aussieht (was wir generieren, was nicht, wie ein ausgebildeter Filmemacher mit den Modellen arbeitet), beschreiben wir auf der Serviceseite KI-Content-Produktion.
Wie funktionieren Bildgenerierungsmodelle?
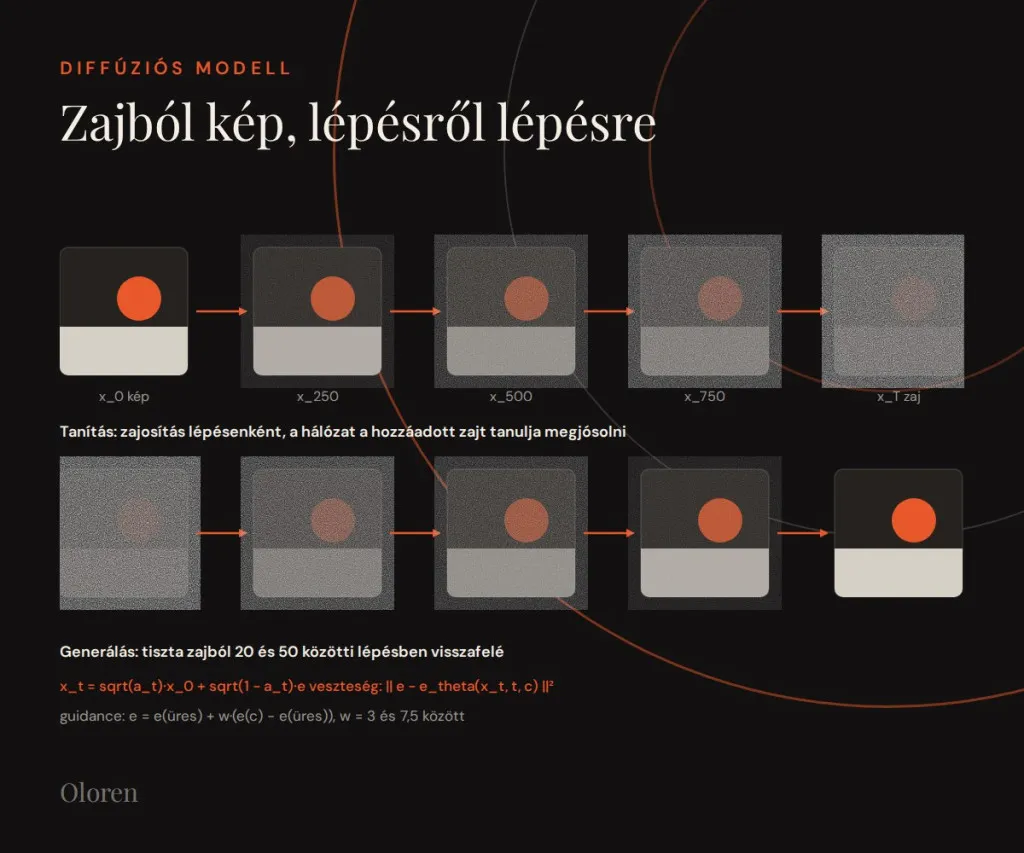
Diffusionsmodell: vom Rauschen zum Bild
Die meisten 2026 eingesetzten Bildgeneratoren arbeiten nach dem Diffusionsprinzip (DDPM, Ho et al., 2020). Beim Training fügt das Modell einem sauberen Bild Schritt für Schritt immer mehr zufälliges Rauschen hinzu, bis das Bild vollständig zu Rauschen wird, und lernt dabei vorherzusagen, wie viel Rauschen in einem bestimmten verrauschten Zustand im Bild steckt. Bei der Generierung kehrt sich der Prozess um: Wir starten mit reinem Rauschen, und das Netz entfernt Schritt für Schritt das vorhergesagte Rauschen, bis nur noch ein Bild übrig bleibt.
Der Trainingsschritt des Algorithmus: x_t = sqrt(a_t) * x_0 + sqrt(1 - a_t) * e, wobei x_0 das saubere Bild, e das Rauschen und a_t der Rauschplan ist; das Netz minimiert den Verlust || e - e_theta(x_t, t, c) ||^2, wobei c die Textbedingung ist. Bei der Generierung (DDIM-Sampling) reichen 20 bis 50 Schritte statt der ursprünglichen 1000.
Die Stärke des Prompts regelt die Classifier-free Guidance: Das Netz läuft zweimal, mit und ohne Bedingung, und die Differenz der beiden wird mit einem Faktor w verstärkt (e = e(leer) + w * (e(c) - e(leer))). Ein größeres w liefert ein treueres, aber weniger abwechslungsreiches und leicht übersättigtes Bild; in der Praxis sind Werte zwischen 3 und 7,5 typisch.
Latenter Raum: die komprimierte Form des Bildes
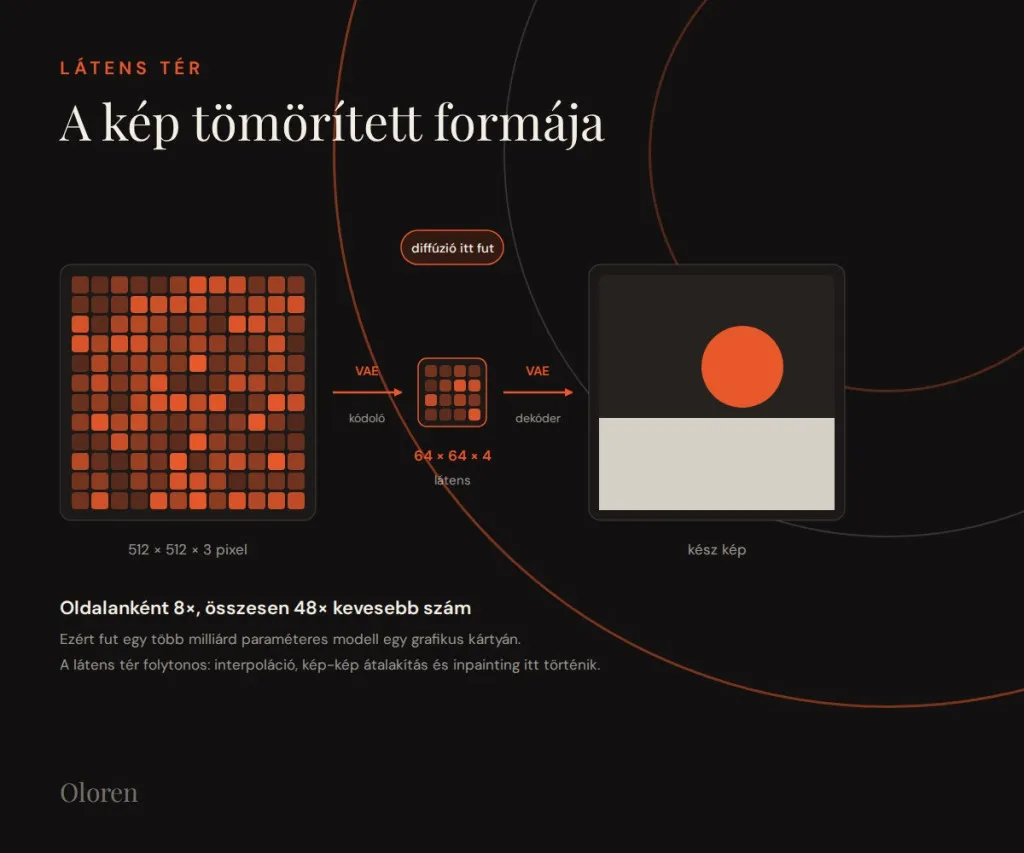
Die Diffusion läuft nicht auf den Pixeln, sondern in einer komprimierten Repräsentation (Latent Diffusion, Rombach et al., 2021). Ein Variational Autoencoder (VAE) verdichtet das Bild mit 512×512×3 Pixeln auf 64×64×4 Werte, also pro Seite auf ein Achtel und insgesamt auf rund 48-mal weniger Zahlen. Das Verrauschen und Entrauschen findet in diesem latenten Raum statt, am Ende stellt der Decoder des VAE die Pixel wieder her.
Das ermöglicht es, dass ein Modell mit mehreren Milliarden Parametern auf einer einzigen Grafikkarte läuft, und deshalb heißt diese Modellfamilie Latent Diffusion. Der latente Raum ist kontinuierlich: Interpoliert man zwischen zwei Punkten, entstehen sinnvolle Zwischenbilder. Das ist die Grundlage von Variationen, Bild-zu-Bild-Umwandlung und Inpainting (dem Neugenerieren eines Bildteils entlang einer Maske).
Textencoder und Cross-Attention: wie der Prompt ins Bild kommt
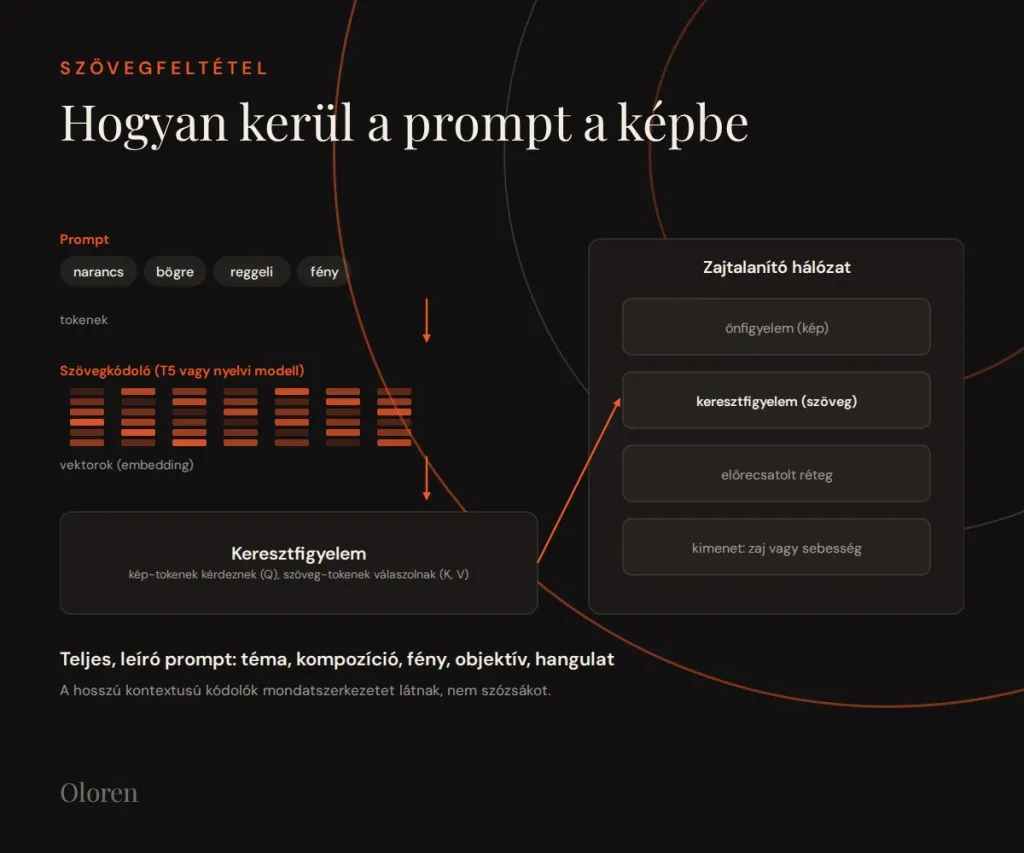
Der Prompt wird zunächst in Tokens zerlegt, dann ordnet ein Textencoder (in frühen Modellen CLIP, heute T5 oder ein Sprachmodell) jedem Token einen Zahlenvektor zu. Diese Vektoren gelangen in die Attention-Schichten des Entrauschungsnetzes: Die Bild-Tokens "fragen" (Query), die Text-Tokens "antworten" (Key, Value), sodass das Netz bei jedem Bilddetail weiß, welches Wort sich darauf bezieht.
Die Bildqualität bei Textdarstellung und komplexen Kompositionen hat sich seit 2024 deshalb so sichtbar verbessert, weil der kurze CLIP-Encoder mit 77 Tokens durch Sprachmodelle mit langem Kontext ersetzt wurde: Das Modell sieht keinen Wortsack mehr, sondern Satzstruktur. In der Praxis schreiben wir deshalb einen vollständigen, beschreibenden Prompt (Motiv, Komposition, Licht, Objektiv, Stimmung) und keine Stichwortliste.
Flow Matching und Diffusion Transformer
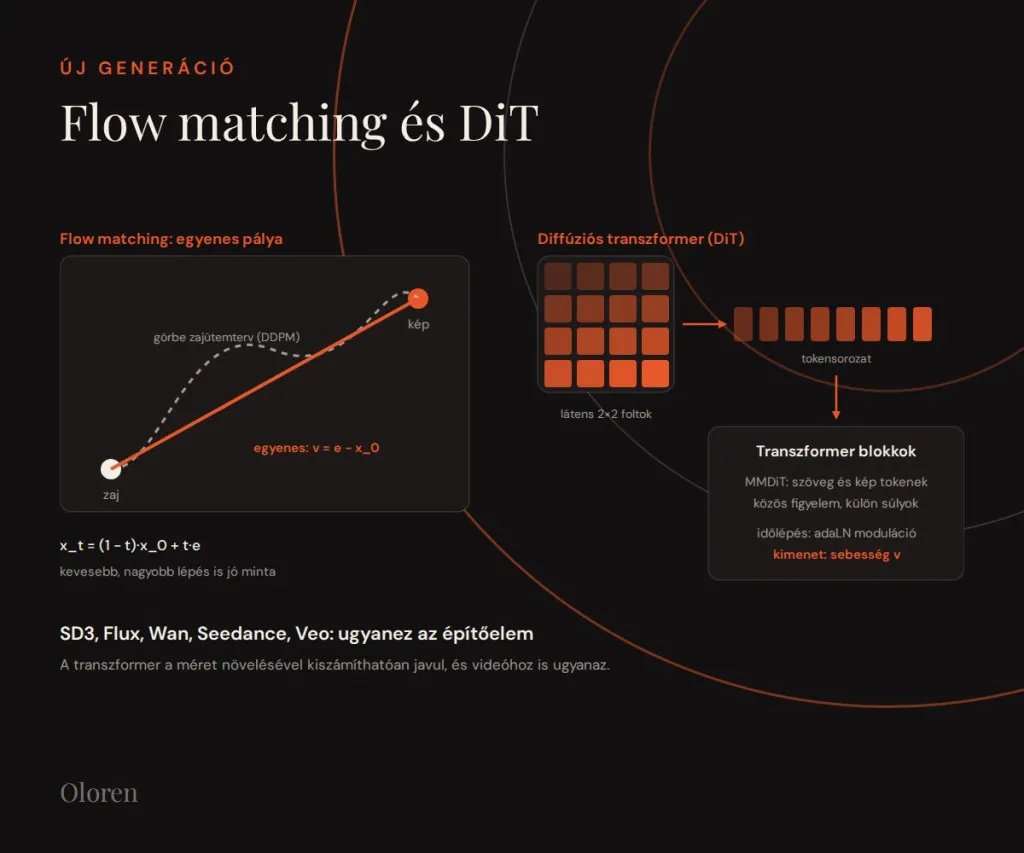
Die Bild- und Videomodelle der Jahre 2025 und 2026 (Stable Diffusion 3, Flux, Wan, Seedance, Veo) brachten zwei Neuerungen. Flow Matching (Lipman et al., 2022) zieht statt eines gekrümmten Rauschplans eine gerade Linie zwischen Bild und Rauschen, und das Modell lernt die Geschwindigkeit entlang dieser Geraden: x_t = (1 - t) * x_0 + t * e, Ziel v = e - x_0. Dank der geraden Bahn ist die Probe auch mit weniger, größeren Schritten gut.
Der Diffusion Transformer (DiT, Peebles und Xie, 2022) ersetzt das frühere U-Net: Er zerlegt das latente Bild in 2×2-Patches, macht daraus eine Token-Sequenz und verarbeitet sie mit einem Standard-Transformer. Die MMDiT-Variante (SD3, Flux) behandelt Text- und Bild-Tokens in einem gemeinsamen Attention-Block, aber mit getrennten Gewichtssätzen, sodass die beiden Modalitäten in beide Richtungen kommunizieren. Der Vorteil des Transformers: Er verbessert sich mit wachsender Größe vorhersehbar, und derselbe Baustein dient auch für Video.
GAN, VAE, autoregressiv: die übrigen Modellfamilien
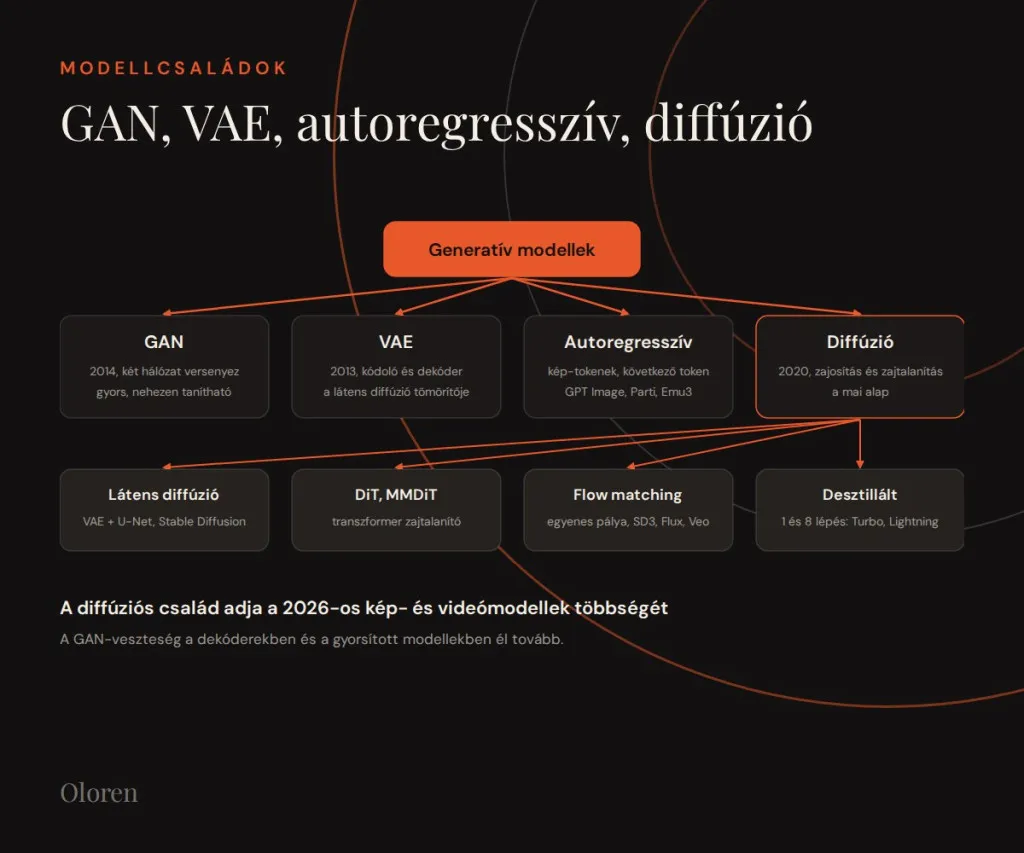
GAN (Goodfellow et al., 2014): Zwei Netze konkurrieren, der Generator erzeugt Bilder, der Diskriminator unterscheidet echt von falsch. Es generiert in einem Schritt und ist daher schnell, aber schwer zu trainieren; heute lebt es als interner Verlust in VAE-Decodern und in beschleunigten Modellen mit wenigen Schritten weiter.
VAE (Kingma und Welling, 2013): Encoder und Decoder mit einer regulierten latenten Verteilung dazwischen. Für sich allein liefert er unscharfe Bilder, ist aber die Komprimierungsstufe der Latent Diffusion.
Autoregressives Token-Modell (VQ-VAE, VQGAN, Parti, Emu3): Es zerlegt das Bild in ganze Zahlen eines gelernten Codebuchs, und ein Sprachmodell sagt das nächste Bild-Token genauso voraus wie das nächste Wort. Nach diesem Prinzip arbeitet auch die GPT-Image-Linie von OpenAI, ein nativ in das Sprachmodell eingebauter Bildgenerator: Er schreibt exakten Text ins Bild und beherrscht mehrstufiges Bearbeiten, decodiert dafür aber langsamer und sequenziell.
Konsistenz- und destillierte Modelle (Song et al., 2023): Ein "Schüler" lernt, die Ausgabe eines mehrstufigen "Lehrer"-Modells in 1 bis 8 Schritten nachzuahmen. Das sind die Turbo-, Lightning- und Fast-Varianten, die innerhalb von Sekunden eine Vorschau liefern.
Die Diffusionsgenerierung Schritt für Schritt
Eine Text-zu-Bild-Generierung besteht in der Praxis aus den folgenden Schritten. 1. Tokenisierung: Der Prompt wird in eine Token-Sequenz umgewandelt. 2. Kodierung: Der Textencoder ordnet jedem Token einen Vektor zu. 3. Initialisierung: Im latenten Raum wird zufälliges Rauschen gezogen (der "Seed" ist dessen Ausgangspunkt, deshalb lässt sich dasselbe Bild mit demselben Seed wiederholen). 4. Entrauschungsschleife: In 20 bis 50 Schritten sagt das Netz das Rauschen oder die Geschwindigkeit voraus, die Guidance verstärkt die Wirkung des Prompts, und die Probe rückt einen Schritt näher an das saubere Bild. 5. Dekodierung: Der VAE erzeugt aus den latenten Werten Pixel. 6. Nachbearbeitung: Sicherheitsfilter, unsichtbares Wasserzeichen (zum Beispiel SynthID), signierte Herkunftsdaten (C2PA), Hochskalierung.
Was davon in der Produktion zählt: Das Festlegen von Seed und Schrittzahl macht das Ergebnis reproduzierbar; der Guidance-Wert ist der Kompromiss zwischen Treue und Vielfalt; die Größe des latenten Raums (1K-, 2K-, 4K-Ausgabe) bestimmt Detailreichtum und Laufzeit zugleich; und Wasserzeichen und Herkunftsdaten sind die technische Grundlage der Kennzeichnungspflicht 2026.
Womit werden die Modelle trainiert, und wie werden die Daten gelabelt?
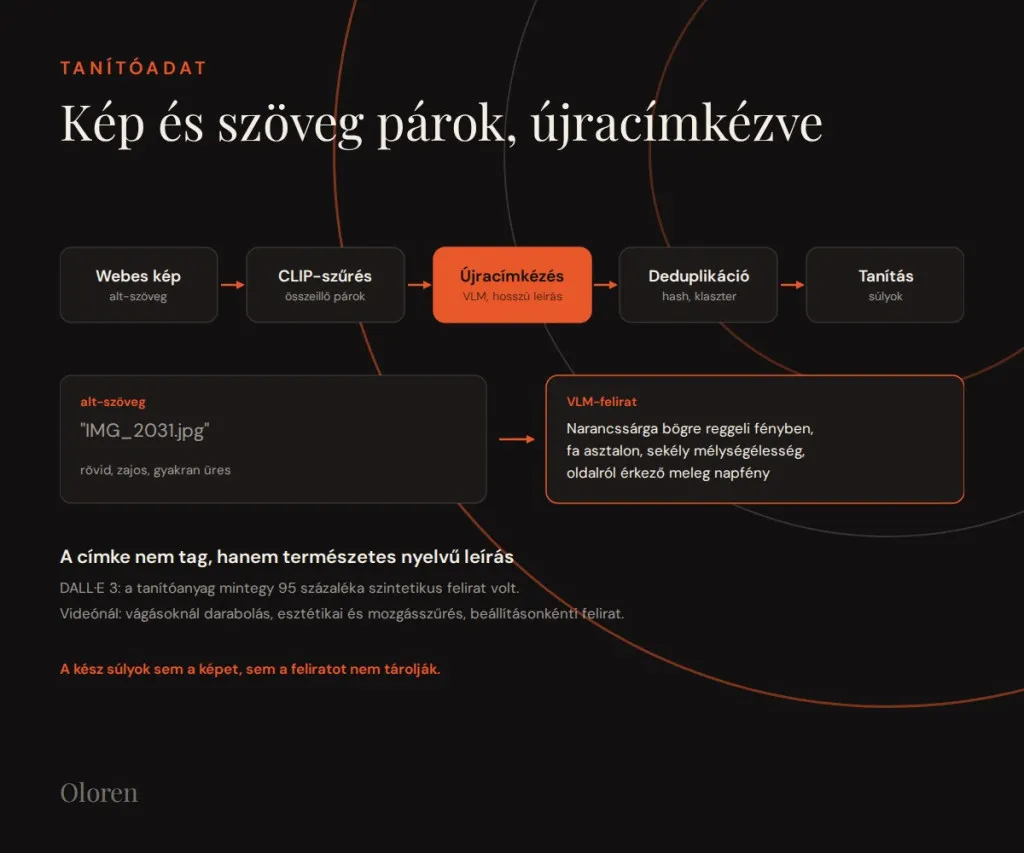
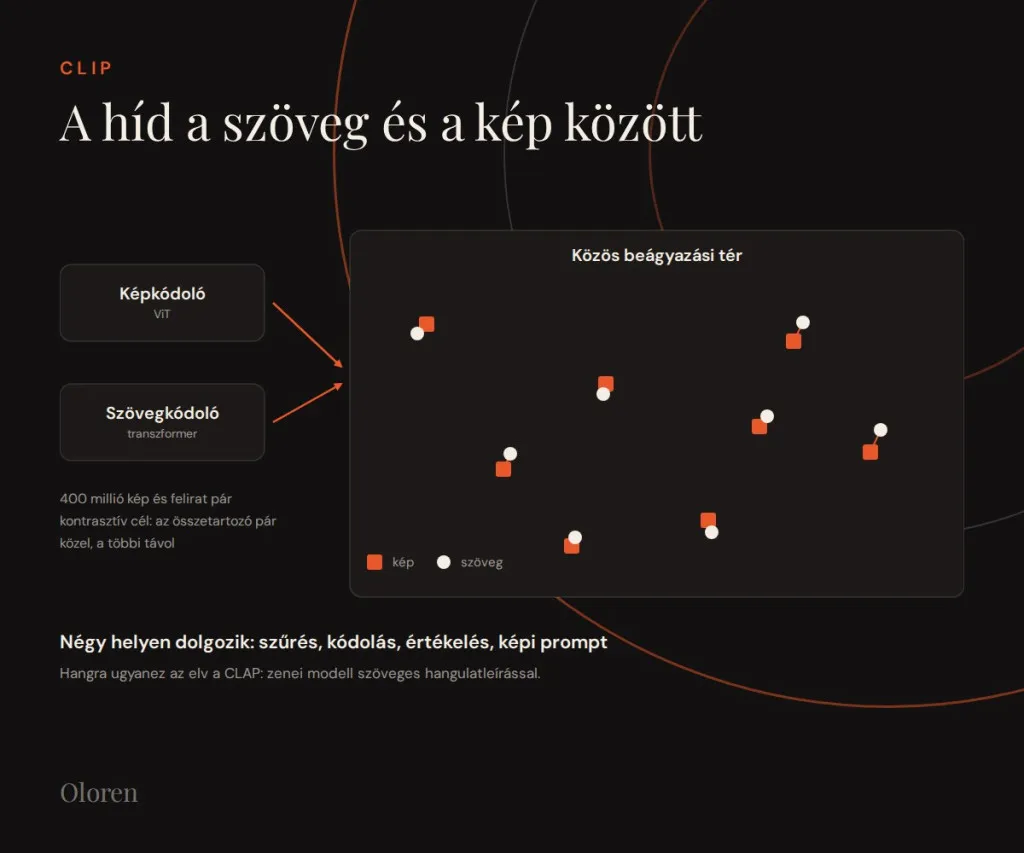
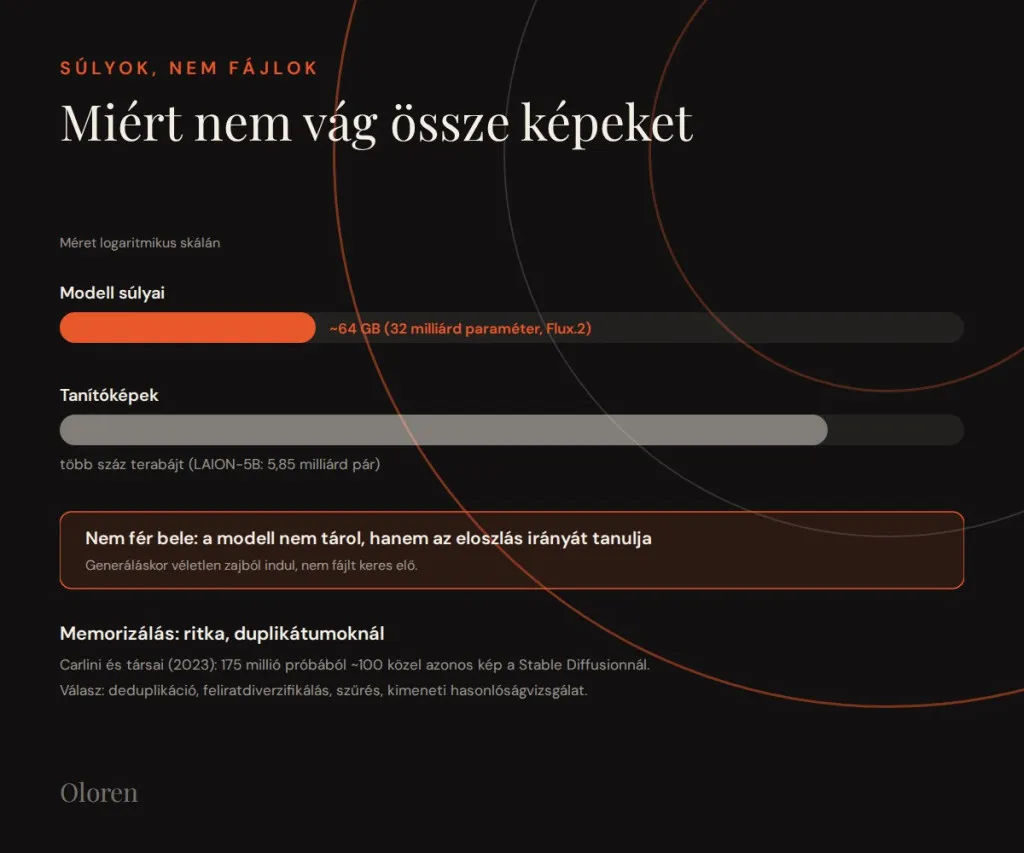
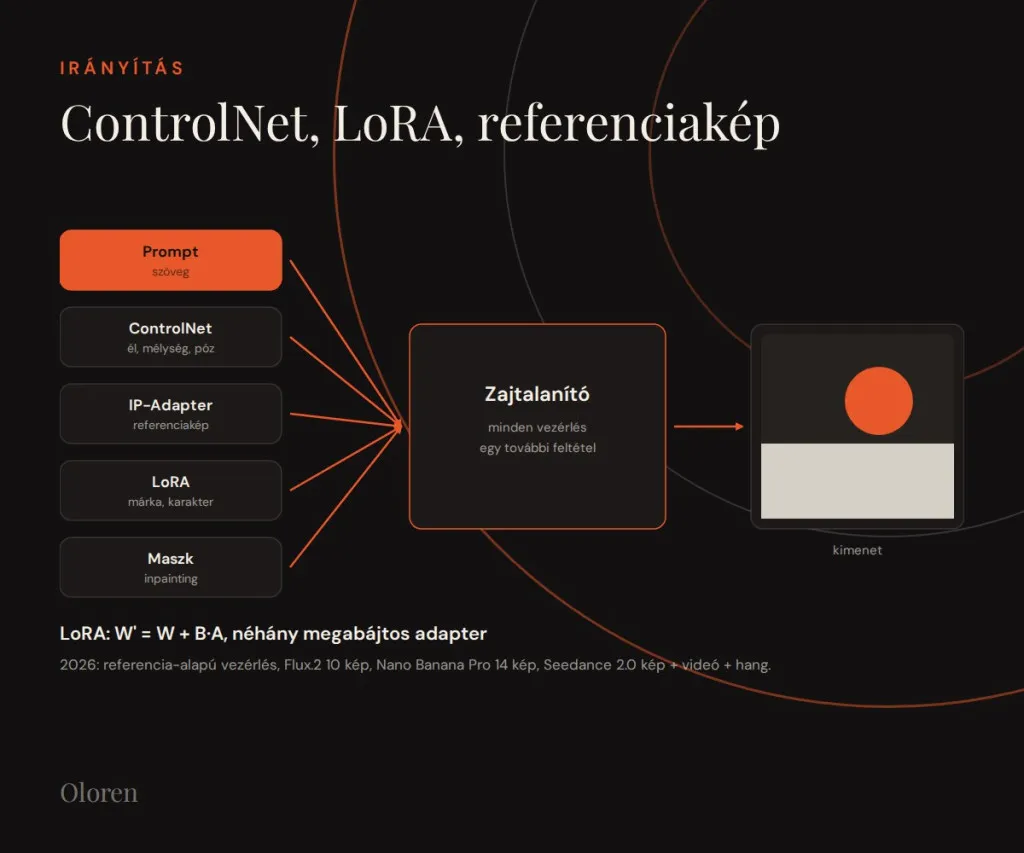
Bild-Text-Paare: die Trainingsdaten
Das Trainingsmaterial von Bildmodellen besteht aus Bild-Text-Paaren. Die öffentlichen Datensätze (zum Beispiel LAION-5B mit 5,85 Milliarden Paaren) stammen aus Web-Scraping: Zum Bild kommt der Alt-Text der Seite, dann filtert ein CLIP-Ähnlichkeitsschwellenwert die nicht zusammenpassenden Paare heraus. Alt-Texte sind kurz und verrauscht, deshalb labeln die Labore heute neu: Ein Bild-Sprach-Modell (VLM) schreibt zu jedem Bild eine lange, detaillierte Beschreibung. Laut der DALL·E-3-Dokumentation von OpenAI bestand das Trainingsmaterial zu rund 95 Prozent aus solchen synthetischen Bildunterschriften, und das brachte die bessere Prompt-Treue.
Bei Video werden die Clips an den Schnitten zerlegt, durch Ästhetik-, Bewegungs- und Textfilter geschickt und dann pro Einstellung beschriftet. Das Label ist also kein "Tag" in einer Datenbank, sondern eine natürlichsprachliche Beschreibung, aus der das Modell die gemeinsame Verteilung von Text und Bild lernt. In den fertigen Gewichten speichert das Modell weder das Bild noch die Bildunterschrift.
CLIP: die Brücke zwischen Text und Bild
CLIP (Radford et al., 2021) trainiert zwei Encoder gleichzeitig, einen Bildencoder und einen Textencoder, auf 400 Millionen Bild-Beschriftungs-Paaren mit kontrastivem Ziel. Die Vektoren von zusammengehörigem Bild und Text rücken in einem gemeinsamen Raum nah zusammen, die von nicht zusammengehörigen weit auseinander. Dieses einfache Prinzip arbeitet in heutigen Systemen an vier Stellen: beim Filtern der Trainingsdaten, als Textencoder der frühen Modelle, bei der Bewertung der Ausgabe (CLIP-Score) und als Eingabe für Bild-Prompts (IP-Adapter, Referenzbild).
Dieselbe Idee funktioniert auch für Audio (CLAP), deshalb lässt sich ein Musikmodell mit einer textlichen Stimmungsbeschreibung steuern.
Gewichte, keine Dateien: warum das Modell keine Bilder zusammenschneidet
Das Training kopiert nicht, sondern stellt die Parameter (Gewichte) des Netzes so ein, dass der Entrauscher die Richtung der Trainingsverteilung vorhersagt. Die Größenordnungen sprechen für sich: Ein Bildmodell mit 32 Milliarden Parametern (Flux.2) hat in halber Genauigkeit rund 64 Gigabyte, die Trainingsbilder dagegen umfassen mehrere hundert Terabyte. Der Datensatz passt physisch nicht in die Gewichte, das Modell kann eine Datei also nicht "heraussuchen".
Memorisierung gibt es trotzdem, aber sie ist selten und konzentriert sich auf Duplikate: Carlini et al. (2023) fanden bei Stable Diffusion unter 175 Millionen Versuchen etwa hundert Ausgaben, die einem Trainingsbild nahezu entsprachen, typischerweise bei vielfach wiederholten Bildern. Die Labore reagieren darauf mit Deduplizierung, Diversifizierung der Bildunterschriften, Filterung bekannter Werke und Personen sowie Ähnlichkeitsprüfung der Ausgaben. Aus rechtlicher Sicht steht aber genau diese Memorisierung im Mittelpunkt der europäischen Urteile der Jahre 2025 und 2026, darüber schreiben wir im Rechtskapitel.
Steuerung: ControlNet, LoRA, Referenzbild
Der professionelle Einsatz entscheidet sich nicht im Prompt, sondern in den Bedingungen. Jede Steuerung gibt dem Entrauscher ein weiteres Signal. Bild-zu-Bild (SDEdit): Das Eingabebild wird teilweise verrauscht und von dort weitergeführt, die Stärke bestimmt, wie viel vom Original bleibt. Inpainting und Outpainting: Entlang der Maske wird nur der ausgewählte Bereich neu generiert. ControlNet (Zhang et al., 2023): speist eine Kanten-, Tiefen- oder Posenkarte über einen parallelen Netzzweig ein, so lässt sich die Komposition fixieren, während der Stil frei bleibt. IP-Adapter: Der CLIP-Vektor eines Referenzbilds kommt über einen eigenen Attention-Zweig, das ist der "Bild-Prompt". LoRA (Hu et al., 2021): Die Gewichte des Modells werden nicht umgeschrieben, sondern eine Ergänzung mit niedrigem Rang trainiert (W' = W + B·A), ein Adapter von wenigen Megabyte für ein Produkt, eine Figur oder einen Markenstil. DreamBooth: bindet das Motiv aus 3 bis 5 Fotos an ein seltenes Token.
Die Spitzenmodelle der Jahre 2025 und 2026 vereinfachen das zu einer referenzbasierten, im Kontext lernenden Steuerung: Flux.2 behält bis zu 10, Nano Banana Pro bis zu 14 Referenzbilder (die Identität von 5 Personen), Veo 3.1 hat "Ingredients", Kling 3.0 "Elements", und Seedance 2.0 akzeptiert Bild, Video und Ton als Referenz. Das ermöglicht die Konsistenz von Markenelementen, Produkt und Darsteller von Einstellung zu Einstellung.
Videogenerierung: die Zeit als dritte Dimension
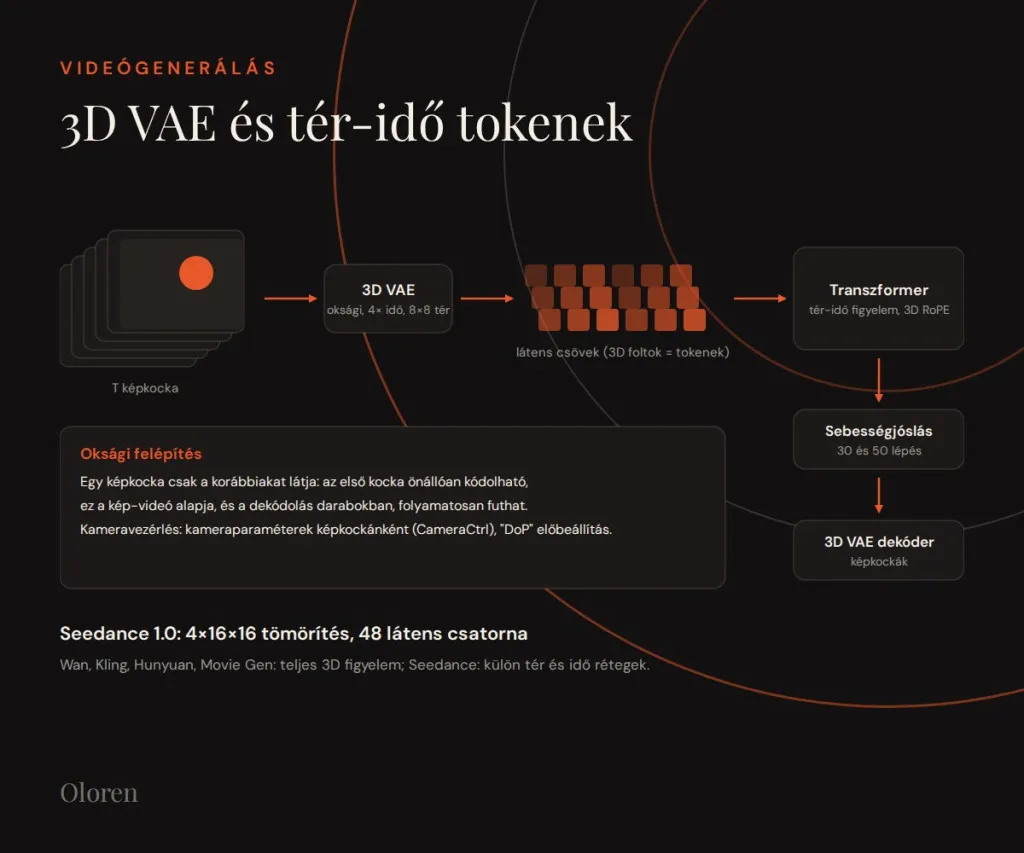
3D-VAE und Raum-Zeit-Tokens
Ein Videomodell nutzt dasselbe latente Diffusionsprinzip, erweitert um die Zeit. Ein kausaler 3D-VAE komprimiert die Einzelbilder räumlich und zeitlich: Wan 2.1 zeitlich um den Faktor 4 und räumlich um 8×8, Seedance 1.0 im Verhältnis 4×16×16 mit 48 latenten Kanälen. Durch den kausalen Aufbau sieht ein Einzelbild nur die vorherigen Bilder, daher lässt sich das erste Bild eigenständig kodieren, das ist die Grundlage von Image-to-Video.
Das latente Video wird in 3D-Patches, "Röhren", geschnitten (zum Beispiel 1×2×2 latente Voxel pro Token), jedes Token erhält einen 3D-Positionscode (Zeit, y, x), anschließend verarbeitet ein Diffusions-Transformer alles zusammen mit den Text-Tokens, entweder mit voller Raum-Zeit-Attention (Wan, Kling, Hunyuan Video, Movie Gen) oder mit getrennten räumlichen und zeitlichen Attention-Schichten (Seedance 1.0). Die Ausgabe wird per Flow-Matching-Geschwindigkeitsvorhersage in 30 bis 50 Schritten berechnet, destilliert in wenigen Schritten, und zum Schluss gibt der Decoder des 3D-VAE die Einzelbilder zurück. Für die Kamerasteuerung werden die Kameraparameter pro Einzelbild als Plücker-Strahlen kodiert (CameraCtrl, 2024), in den Produkten erscheint das als "Director"- oder "DoP"-Voreinstellung.
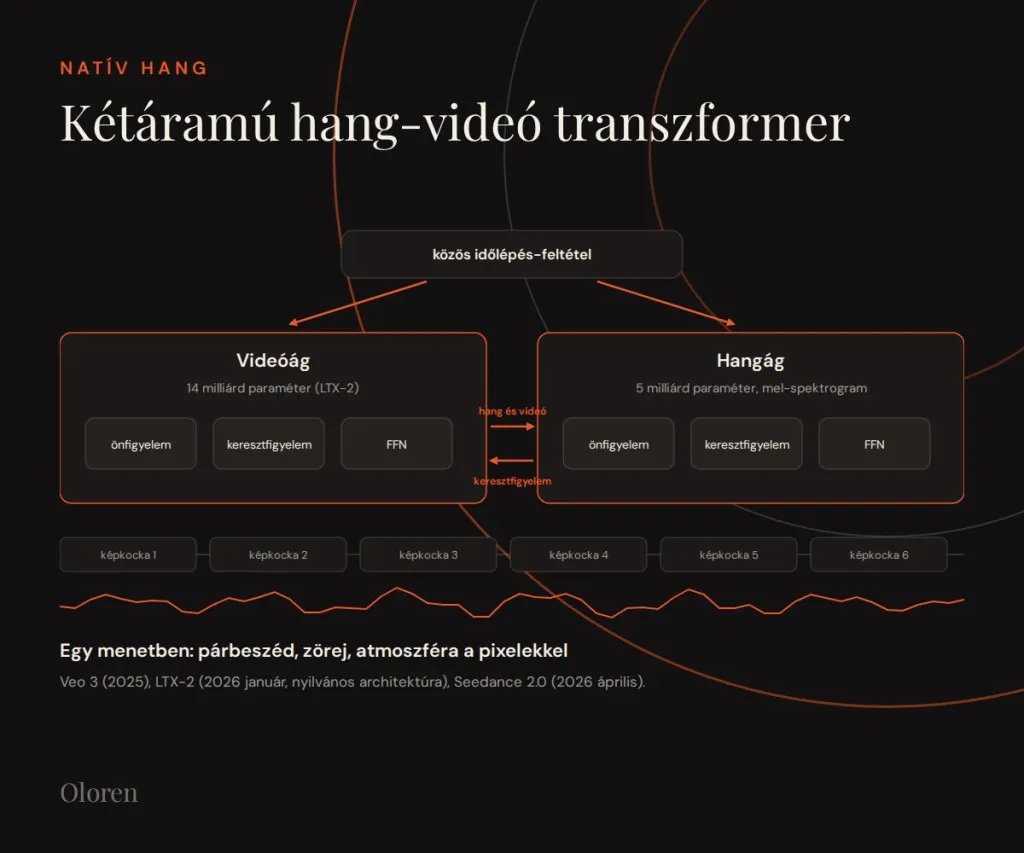
Nativer Ton und mehrere Einstellungen in einer Generierung
Veo 3 (Mai 2025) war das erste verbreitete Modell, das Dialog, Geräusche und Atmosphäre in einem Durchgang zusammen mit den Pixeln erzeugte. Die öffentliche Architektur dafür ist LTX-2 (Lightricks, Januar 2026): ein asymmetrischer Zweistrom-Transformer mit einem Videozweig von 14 Milliarden Parametern und einem Audiozweig von 5 Milliarden Parametern (Mel-Spektrogramm-Latent, ein Token entspricht etwa 1/25 Sekunde), verbunden durch bidirektionale Audio-Video-Cross-Attention mit gemeinsamer Zeitschritt-Konditionierung. Seedance 2.0 (April 2026) akzeptiert Text-, Bild-, Audio- und Videoreferenzen in einer einheitlichen Audio-Video-Generierung.
Längeres Material mit mehreren Einstellungen entsteht auf drei Wegen: Das Modell setzt die letzte Sekunde des vorherigen Clips fort (Veo 3.1 "extend"), es lernt nativ mehrere Einstellungen mit Positionskodierung pro Einstellung und einem Prompt auf Storyboard-Ebene (Seedance, Kling 3.0 Omni), oder es verarbeitet in einem Durchgang einen längeren Kontext (Wan 3.0 und Seedance 2.5: 30 Sekunden). Die Identität von Figuren und Objekten hält eine Referenzbindung ("Elements", "Ingredients") von Einstellung zu Einstellung fest.
Die 2026 verfügbaren Videomodelle
Die Tabelle fasst die im September 2026 öffentlich dokumentierten Fähigkeiten zusammen. Die Werte sind Angaben der Hersteller, die Modelle ändern sich schnell, deshalb prüfen wir sie zu Projektbeginn immer erneut.
| Modell | Länge und Auflösung | Ton | Was man wissen sollte |
|---|---|---|---|
| Google Veo 3.1 | 4, 6, 8 s, 1080p, 4K mit Hochskalierung | nativer Dialog, Geräusche, Musik | "Ingredients"-Referenzen, erstes und letztes Bild, Szenenverlängerung, SynthID-Wasserzeichen auf jeder Ausgabe |
| Kling 3.0 und 3.0 Omni | zwischen 3 und 15 s, 720p, 1080p | nativ, mehrsprachig | Storyboard mit mehreren Einstellungen, "Elements"-Bild- und Videoreferenzen, Veröffentlichung Februar 2026 |
| ByteDance Seedance 2.0 und 2.5 | 4 und 15 s, Version 2.5 30 s | mehrspurig: Musik, Atmosphäre, Sprache | bis zu 9 Bild-, 3 Video- und 3 Audioreferenzen, einheitliche Audio-Video-Architektur |
| Runway Gen-4.5 und Aleph 2.0 | zwischen 2 und 10 s, 720p; Aleph bis 30 s in 1080p | nicht nativ, ElevenLabs-Integration | im Dezember 2025 Platz eins im unabhängigen Ranking; Aleph für die kontextbezogene Bearbeitung echter Aufnahmen |
| Alibaba Wan 2.x und 3.0 | 2.6: 1080p, 15 s; 3.0: 30 s in einem Durchgang | native Audio-Video-Synchronisation | Wan 2.1 mit offenen Gewichten (Apache-2.0), 3.0 nur per API |
| Luma Ray3 | 1080p nativ, 4K mit Hochskalierung | kein nativer Ton | 16-Bit-HDR-Ausgabe (EXR), ein Vorteil beim Farbmanagement |
| OpenAI Sora 2 | 1280×720 | synchronisiert | OpenAI hat die Sora-App am 26. April 2026 und die API am 24. September 2026 eingestellt |
Bildmodelle 2026: Google Nano Banana Pro und Nano Banana 2 (1K, 2K, 4K, bis zu 14 Referenzbilder, SynthID), OpenAI GPT Image 2 (April 2026, nativ in das Sprachmodell integrierte Generierung), Black Forest Labs Flux.2 (32 Milliarden Parameter, offene Dev-Gewichte), Midjourney V8.2 (Juli 2026), Ideogram 4.0 (Juni 2026, offene Gewichte, Typografie), ByteDance Seedream 5.0 Pro (Juli 2026, Zerlegung in 20 Ebenen), Stability AI Stable Diffusion 3.5.
KI für Musik- und Audiogenerierung: Technologie und Regulierung
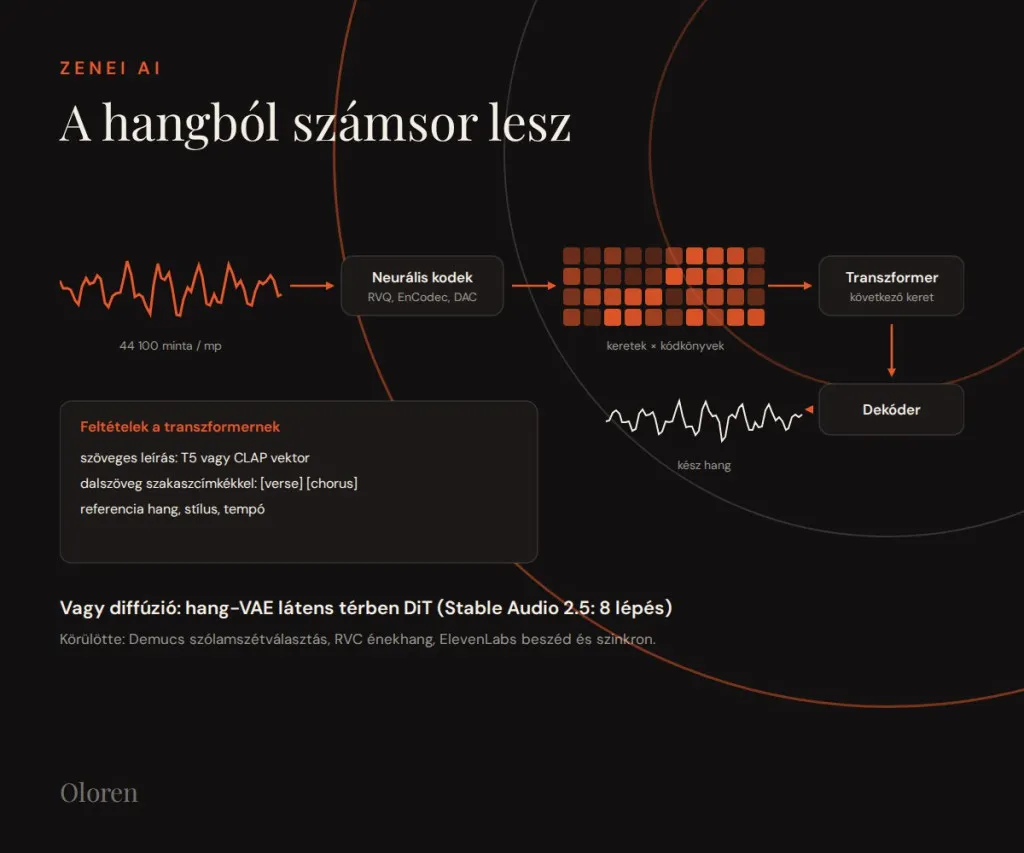
Codec-Tokens: aus Klang wird eine Zahlenfolge
Rohes Audio besteht aus 44.100 Abtastwerten pro Sekunde, für einen Transformer viel zu lang. Musikmodelle komprimieren die Wellenform deshalb mit einem neuronalen Codec (SoundStream, EnCodec, DAC) auf einige Dutzend "Frames" pro Sekunde, und jeder Frame erhält einige ganze Zahlen aus gelernten Codebüchern (Residual-Vektorquantisierung). Von hier aus gibt es zwei Wege. Autoregressive Modelle (MusicLM, MusicGen und die öffentlich dokumentierten Songmodelle wie YuE oder HeartMuLa) sagen mit einem Sprachmodell den nächsten Audio-Frame vorher; die Textbeschreibung geht als T5- oder CLAP-Vektor ein, der Liedtext wird mit Abschnittsmarkierungen ([verse], [chorus]) tokenisiert. Latente Diffusionsmodelle (AudioLDM, Stable Audio 2.0 und 2.5) lassen einen Diffusions-Transformer im latenten Raum eines Audio-VAE laufen; Stable Audio 2.5 liefert in acht Schritten, in unter zwei Sekunden, drei Minuten Musik.
Die Architektur der kommerziellen Systeme (Suno, Udio) ist nicht öffentlich. Um sie herum entsteht die weitere Audio-KI: Stem-Trennung (Demucs), Stimmklonen und Gesangsstimmen-Konvertierung (RVC, ElevenLabs), Sprachsynthese sowie KI-Synchronisation, die die Sprache übersetzt, mit der geklonten Stimme neu synthetisiert und an die Lippenbewegung anpasst.
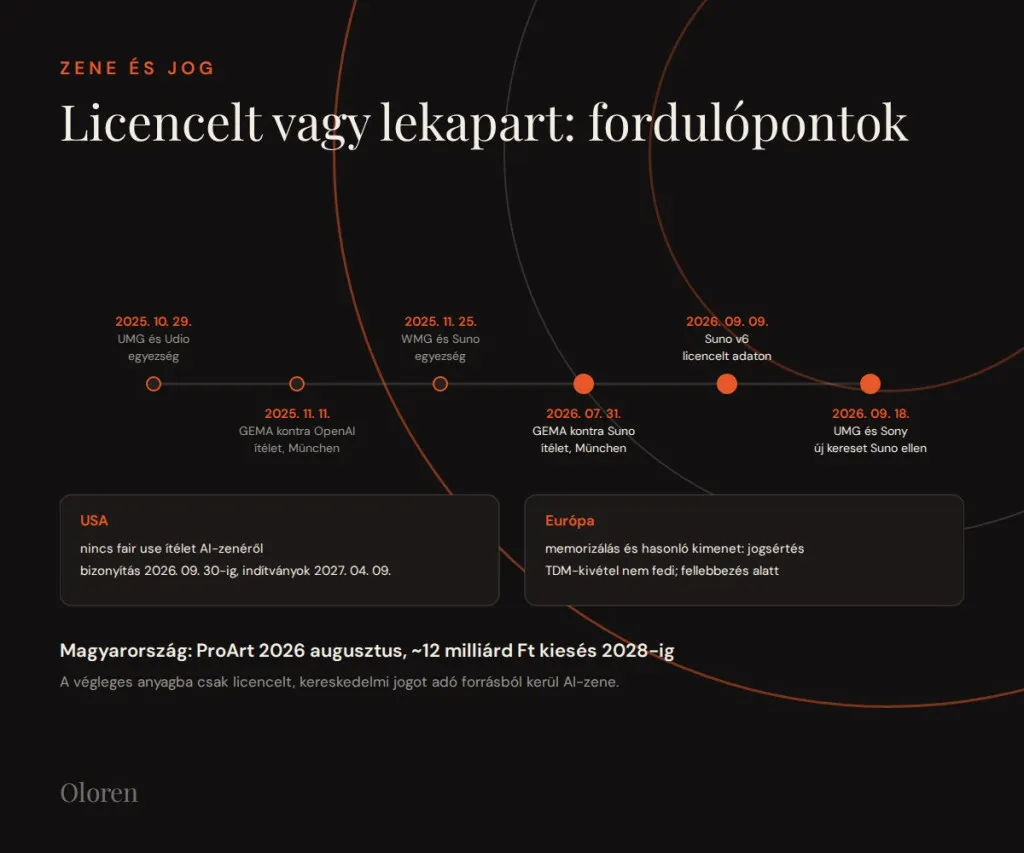
Lizenziert oder abgegriffen: die Wendepunkte von 2025 und 2026
Die rechtliche Landkarte der generativen Musik-KI wurde 2026 neu gezeichnet. Universal einigte sich am 29. Oktober 2025 mit Udio, Warner am 19. November 2025, Warner am 25. November 2025 mit Suno; Suno veröffentlichte am 9. September 2026 die Modellfamilie v6, die nach eigenen Angaben auf von Warner, BMG und Believe lizenziertem Material trainiert wurde. Gleichzeitig reichten Universal und Sony am 18. September 2026 eine neue Klage gegen Suno wegen 60.202 Tonaufnahmen ein, Sony am 20. Juli 2026 gegen Udio, und zur US-amerikanischen Fair-Use-Frage gibt es noch kein Urteil: Im Suno-Verfahren endet die Beweisphase am 30. September 2026, die Frist für die entscheidenden Anträge ist der 9. April 2027.
In Europa sieht es anders aus. Das Landgericht München entschied am 11. November 2025 zugunsten der GEMA gegen OpenAI (das Memorieren von Liedtexten in den Gewichten ist eine Vervielfältigung, die Text-und-Data-Mining-Schranke deckt es nicht ab), und am 31. Juli 2026 auch gegen Suno: Training, Memorieren, Ausgabe und öffentliche Wiedergabe sind gleichermaßen rechtsverletzend, das US-amerikanische Fair-Use-Argument wies es zurück. Beide Verfahren befinden sich in der Berufung. In Ungarn prognostiziert der Musikbranchenbericht von ProArt vom August 2026 bis 2028 einen Ausfall von rund 12 Milliarden Forint bei den Tantiemen ungarischer Komponisten und Interpreten durch KI-Musik.
Plattformregeln 2026: Kennzeichnung, Ausschluss, Verbot
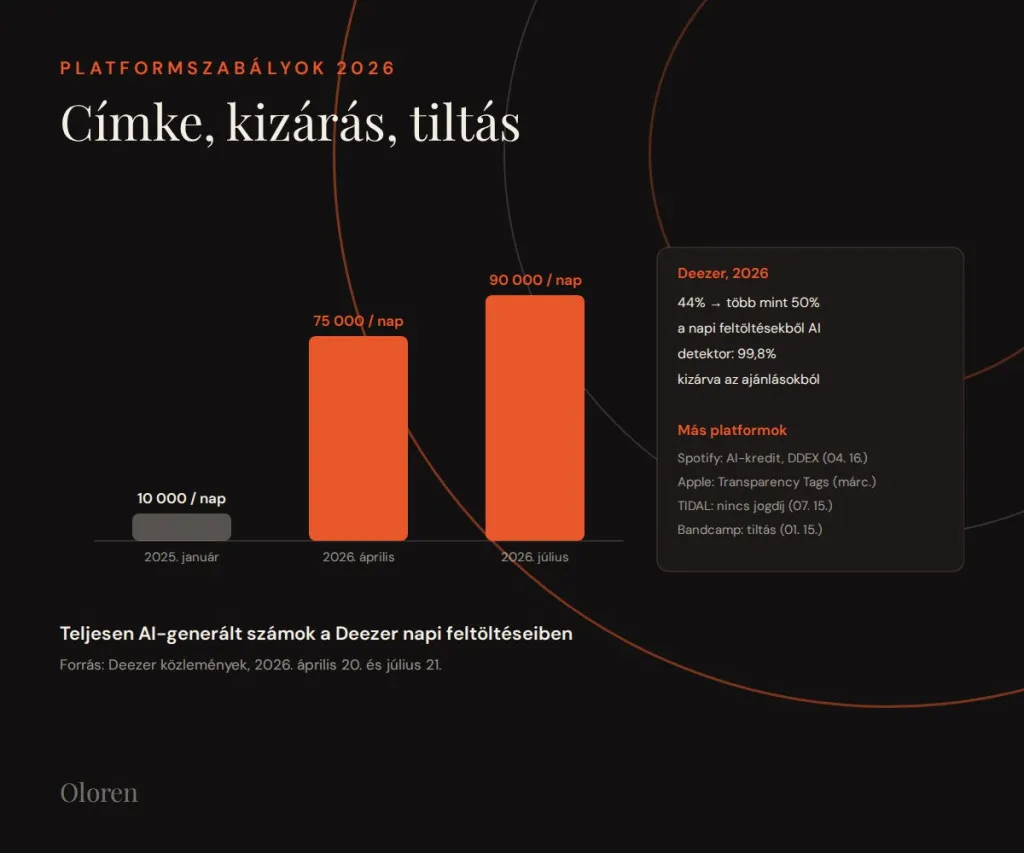
Laut Mitteilung von Deezer vom 20. April 2026 waren 44 Prozent der täglichen Uploads (rund 75.000 Titel pro Tag) vollständig KI-generiert, im Juli 2026 überschritt der Anteil 50 Prozent (etwa 90.000 Titel pro Tag); die Plattform schließt KI-Titel aus den algorithmischen und redaktionellen Empfehlungen aus, ihr Detektor ist nach eigenen Angaben zu 99,8 Prozent genau. Spotify zeigt seit dem 16. April 2026 eine KI-Kennzeichnung nach DDEX-Standard in den Credits, verbietet unautorisierte Stimmklone und arbeitet mit einem Spamfilter; Apple Music verlangt seit März 2026 eine Selbstauskunft per "Transparency Tags"; TIDAL schließt seit dem 15. Juli 2026 vollständig KI-generierte Titel von der Tantiemenverteilung aus; Bandcamp verbietet seit dem 15. Januar 2026 vollständig oder überwiegend mit KI erstellte Musik.
Für Werbung und Content-Produktion ist die Schlussfolgerung einfach: KI-Musik im finalen Material nur von einer lizenzierten Plattform, aus einem Paket mit kommerziellen Rechten, zu dokumentierten Bedingungen; als Stimmungsreferenz, vorläufige Musik (Temp Track) und Sounddesign-Skizze ist sie dagegen das schnellste Werkzeug. Die Stimme oder den Stil echter Künstler klonen wir nicht, das verbieten die Plattformen unabhängig von der Kennzeichnung.
Sprachmodelle: wie ChatGPT, Gemini und Claude funktionieren
Tokenisierung: ein ungarisches Wort zerfällt in mehrere Teile
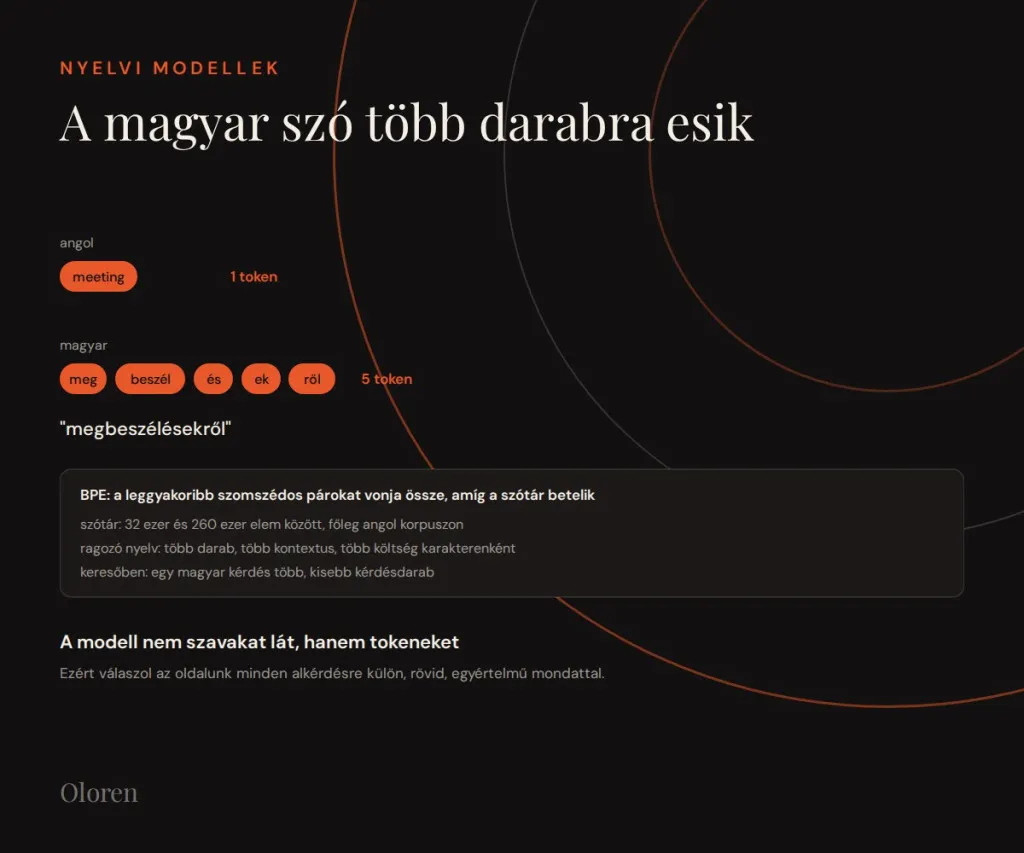
Ein Sprachmodell sieht keine Wörter, sondern Tokens: Teile eines Vokabulars mit 32.000 bis 260.000 Einträgen. Byte-Pair-Encoding (BPE) fasst die häufigsten benachbarten Zeichenpaare zusammen, bis das Vokabular voll ist; SentencePiece lernt auf Rohtext ohne Leerzeichen-Vorverarbeitung. Da die Vokabulare vor allem auf englischen Korpora entstehen, zerfällt das agglutinierende Ungarisch stärker: Ein englisches Wort ist typischerweise ein Token, "megbeszélésekről" dagegen 3 bis 6 Tokens.
Das hat drei praktische Folgen. Ungarischer Text verbraucht pro Zeichen mehr Kontext und mehr Geld; das Modell ist auf Ungarisch etwas schwächer als auf Englisch; und in Suchmaschinen bedeutet eine ungarische Frage mehr Tokens, also mehr und kleinere "Fragefragmente", auf die unsere Seite jeweils einzeln antworten muss.
Attention: die Grundoperation des Transformers
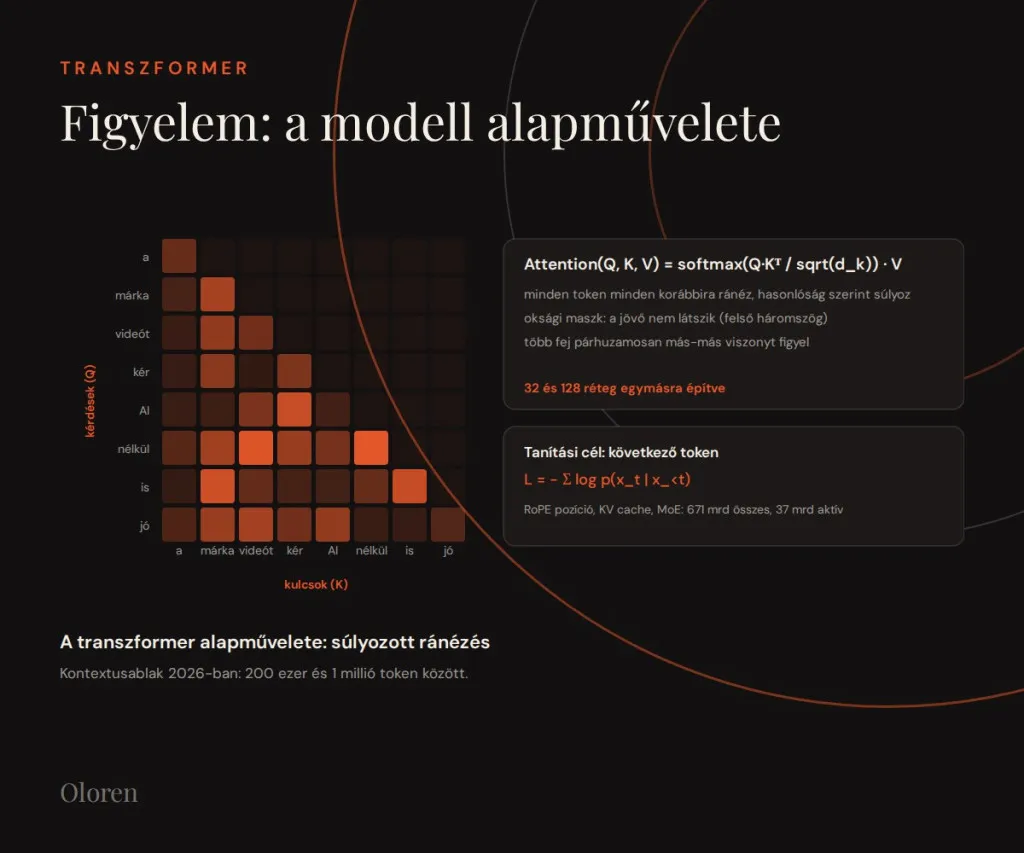
Der Transformer (Vaswani et al., 2017) berechnet für jedes Token drei Vektoren: Query (Q), Key (K), Value (V). Die Attention-Formel: Attention(Q, K, V) = softmax(Q·K^T / sqrt(d_k)) · V. Jedes Token "schaut" auf jedes frühere Token, gewichtet es nach Ähnlichkeit und trägt die Summe der gewichteten Werte weiter. In einem Decoder-Modell verbietet eine kausale Maske den Blick in die Zukunft. Mehrere Köpfe (Multi-Head) achten parallel auf jeweils andere Beziehungen, den Block ergänzen ein Feedforward-Netz, eine Residualverbindung und eine Normalisierung, und davon werden 32 bis 128 Schichten übereinander gestapelt.
Die Position liefert eine rotierende Kodierung (RoPE): Die Q- und K-Vektoren werden um einen zur Position proportionalen Winkel gedreht, sodass das Skalarprodukt nur vom relativen Abstand abhängt. Das Trainingsziel ist die Kreuzentropie des nächsten Tokens: L = - sum_t log p(x_t | x_<t). Beim Antworten sampelt das Modell Token für Token (Temperatur, Top-p), hält die früheren Keys und Values in einem Cache (KV-Cache), und das Kontextfenster bewegt sich 2026 zwischen 200.000 und 1 Million Tokens. Mixture-of-Experts-Modelle (MoE) aktivieren pro Token nur wenige "Experten"-Teilnetze, deshalb kann ein Modell mit 671 Milliarden Parametern 37 Milliarden aktive Parameter haben.
Trainingsstufen: Vortraining, Feinabstimmung, RLHF, Reasoning
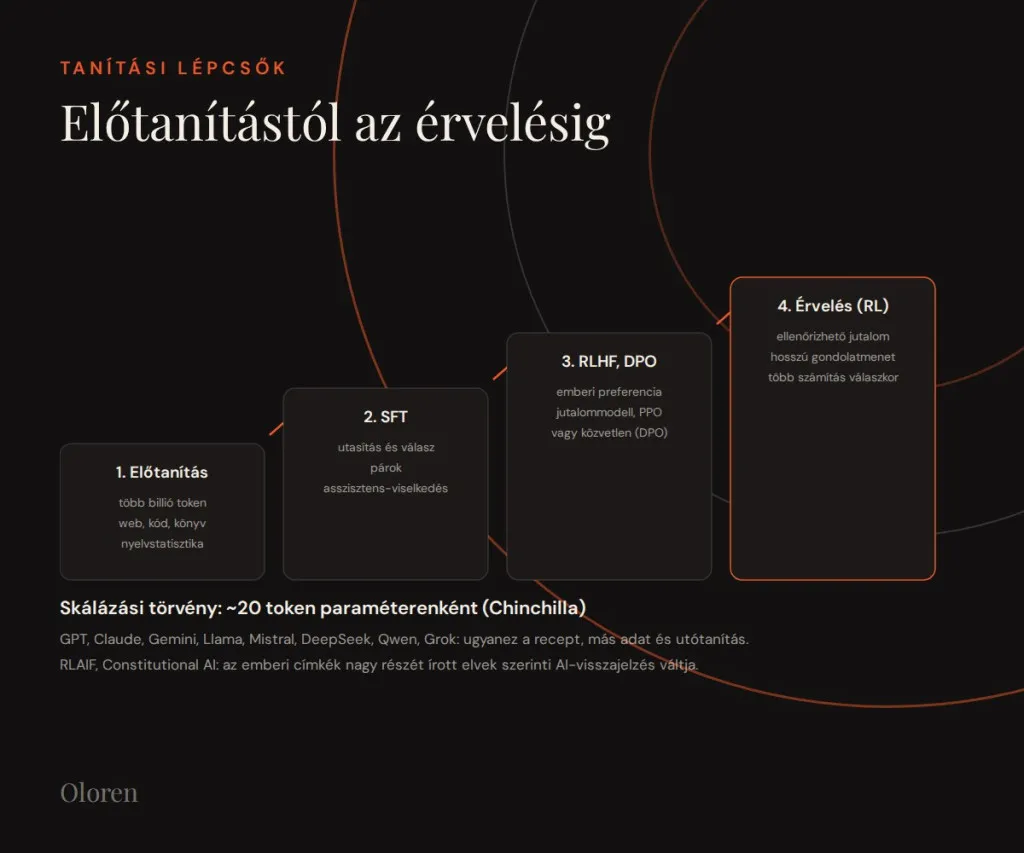
1. Vortraining auf mehreren Billionen Tokens aus Webtexten, Code und Büchern: Das Modell lernt die Statistik der Sprache, es ist noch kein "Assistent". 2. Überwachte Feinabstimmung (SFT) auf Paaren aus Anweisung und Antwort. 3. RLHF (Ouyang et al., 2022): Menschen bewerten Antwortpaare, daraus entsteht ein Belohnungsmodell, und das Sprachmodell wird per bestärkendem Lernen (PPO) auf die Belohnung optimiert, mit einer KL-Strafe, damit es sich nicht vom SFT-Modell entfernt. DPO (2023) lässt das Belohnungsmodell weg und lernt die Präferenzen direkt; RLAIF und Constitutional AI ersetzen den Großteil der menschlichen Labels durch KI-Feedback auf Basis schriftlicher Grundsätze. 4. Reasoning-Modelle: Durch bestärkendes Lernen auf überprüfbaren Belohnungen (korrekte Mathematik- oder Codeantworten) lernt das Modell lange Gedankengänge (DeepSeek-R1, 2025) und nutzt zur Antwortzeit mehr Rechenleistung.
Nach den Skalierungsgesetzen (Kaplan 2020, Chinchilla 2022) sinkt der Verlust als Potenzfunktion mit mehr Parametern, Daten und Rechenleistung, und rechenoptimales Training nutzt etwa 20 Tokens pro Parameter. Die Spitzenmodelle von 2026 (die Familien GPT, Claude, Gemini, Llama, Mistral, DeepSeek, Qwen und Grok) folgen alle diesem Rezept, der Unterschied liegt in den Daten, der Größe, der Multimodalität und dem Nachtraining.
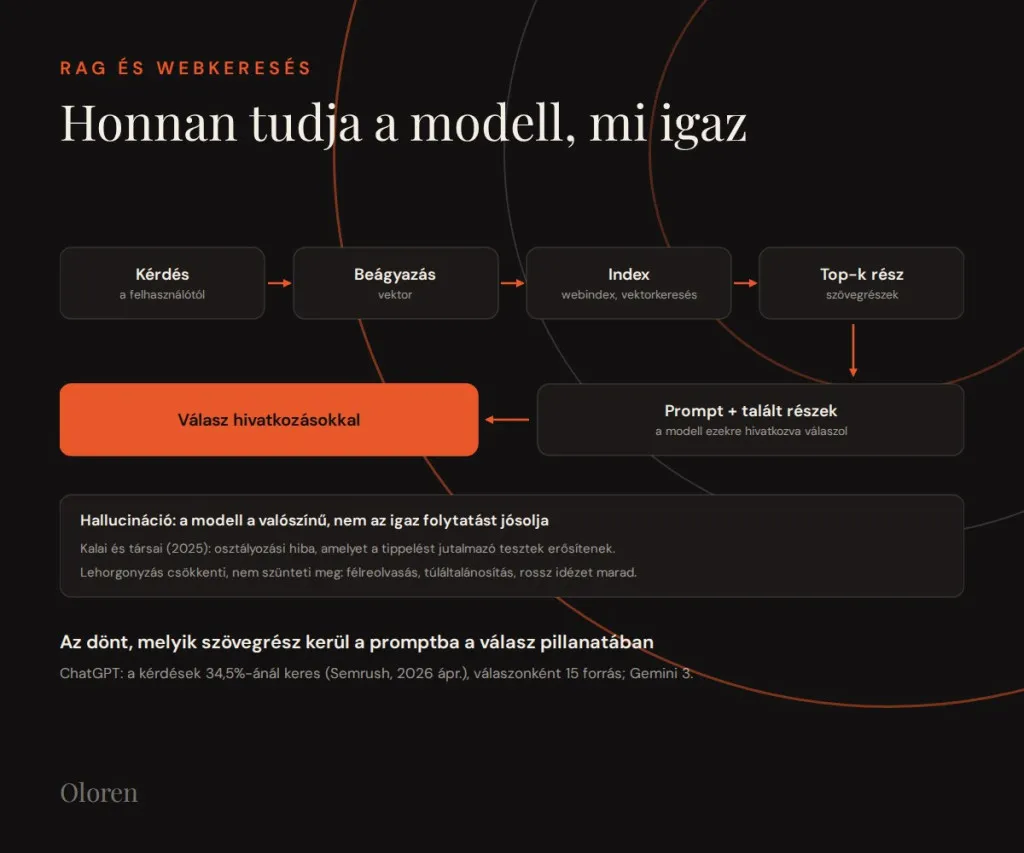
RAG und Websuche: woher das Modell weiß, was wahr ist
Ein Sprachmodell sagt das nächste wahrscheinliche Token voraus, nicht die Wahrheit: Deshalb halluziniert es. Laut Kalai et al. (OpenAI, 2025) entsteht Halluzination als einfacher Klassifikationsfehler, und Benchmarks verstärken sie, weil sie Raten stärker belohnen als Zurückhaltung. Die Lösung ist die Verankerung: Retrieval-Augmented Generation (RAG, Lewis et al., 2020) wandelt die Frage in einen Vektor um, sucht in einem Index die nächstliegenden Textstellen, fügt sie in den Prompt ein, und das Modell antwortet mit Bezug auf diese. KI-Suchmaschinen (ChatGPT search, Perplexity, Google AI Mode, Gemini, Copilot, Claude, Grok) folgen demselben Schema, wobei der Retriever ein Webindex ist.
Daraus folgt der Kern von GEO: Entscheidend ist nicht, was das Modell "weiß", sondern welche Textstelle im Moment der Antwort in den Prompt gelangt. Laut der Semrush-Untersuchung vom April 2026 nutzt ChatGPT bei 34,5 Prozent der Anfragen die Websuche, laut dem AI Visibility Index vom Juni 2026 zitiert es durchschnittlich 15 Quellen pro Antwort, Gemini drei. Das Modell kann sich auch dann irren, wenn es eine gute Quelle erhalten hat: Es verliest sich, verallgemeinert zu stark oder zitiert ein Detail, das die Aussage nicht stützt. Deshalb ist eine zitierfähige, eindeutige, mit Daten belegte Seite auch der beste Schutz gegen falsches Zitieren.
KI-Suchmaschinen und GEO: Wie die Maschine eine Quelle auswählt
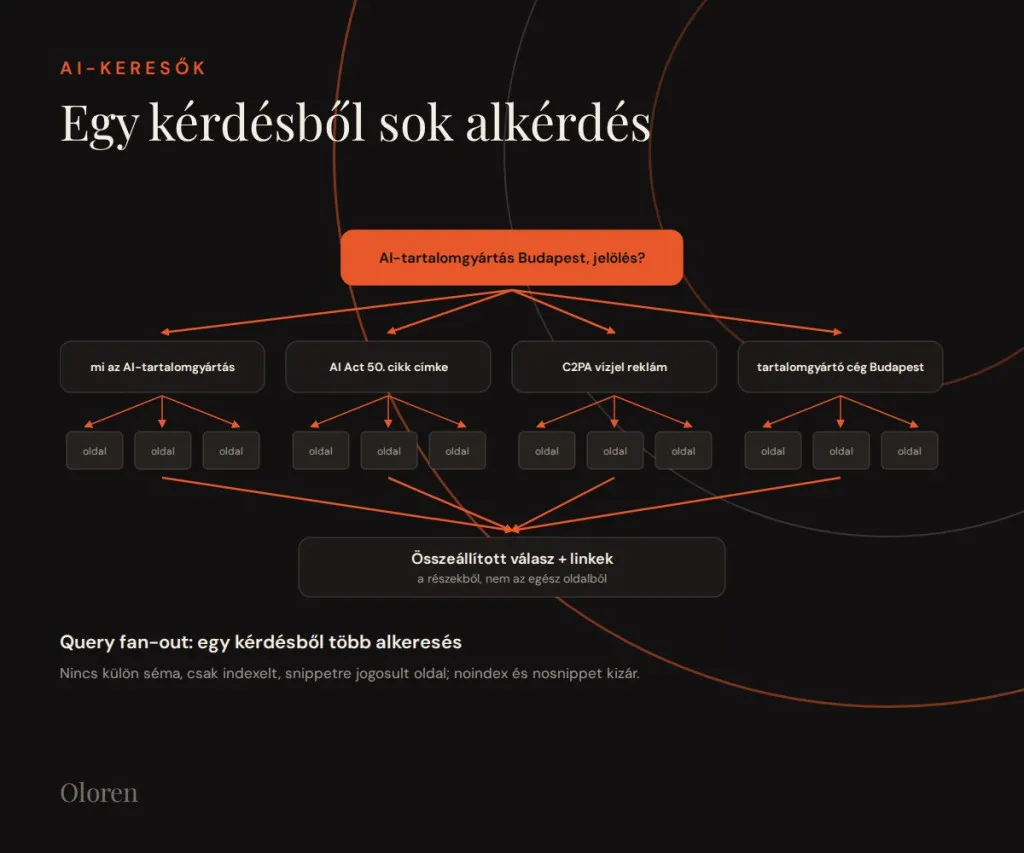
Query Fan-out: Aus einer Frage werden viele Teilfragen
Laut Googles Dokumentation verwenden AI Overviews und AI Mode die Technik des "Query Fan-out": Die Frage des Nutzers wird nach Themen und Datenquellen in mehrere verwandte Teilsuchen zerlegt, und das Gemini-basierte Modell stellt die Antwort aus den so gefundenen Seiten zusammen und verlinkt sie. Es gibt keine gesonderte technische Anforderung und keine gesonderten strukturierten Daten, die hinzugefügt werden müssten; die Seite muss indexiert und snippetberechtigt sein, nosnippet und noindex schließen sie aus. Die Robots-Regel Google-Extended betrifft nur das Training und die Verankerung von Gemini, nicht AI Overviews und AI Mode.
Die praktische Folge: Die Seite konkurriert nicht um ein Hauptkeyword, sondern um Teilfragen. ChatGPT-Prompts, die eine Suche auslösen, sind im Schnitt 8,7 Wörter lang (Semrush, April 2026), gesprochene Fragen mit mehreren Absichten statt des klassischen Keywords aus 2 bis 4 Wörtern. Deshalb schreiben wir unter jede H2 und H3 in den ersten ein bis zwei Sätzen eine direkte Antwort, und deshalb erhält jede Aussage eine benannte Quelle und ein Datum.
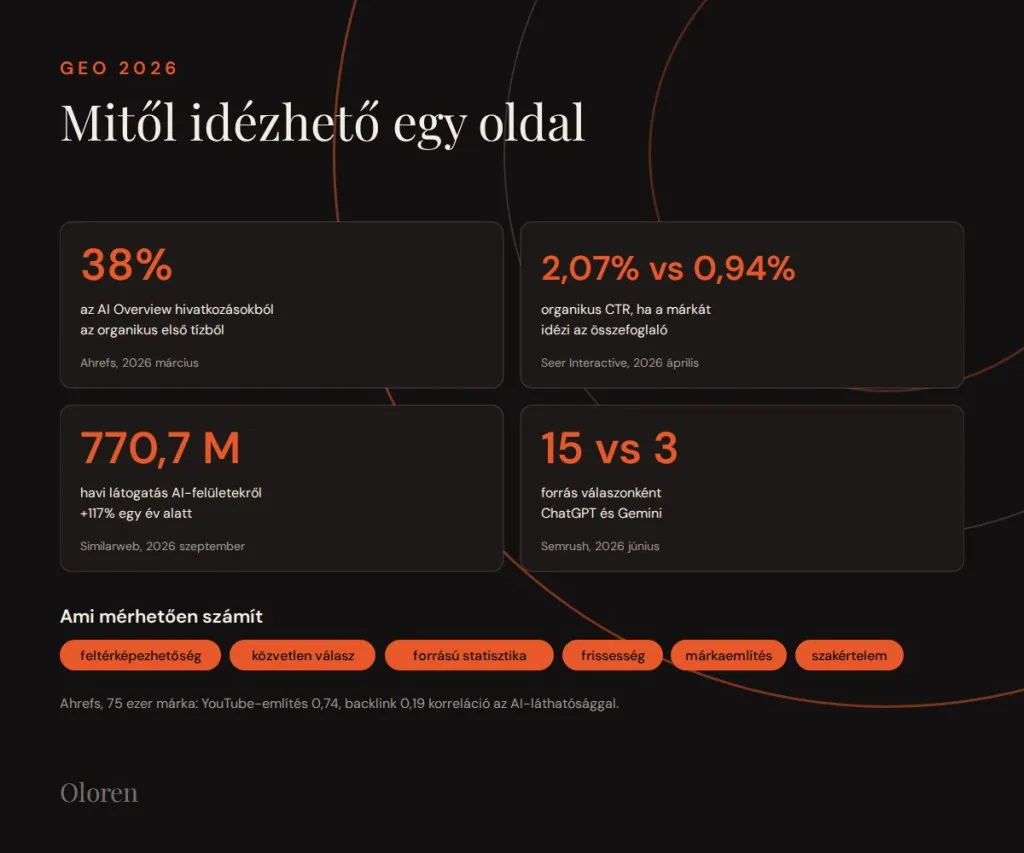
Was eine Seite 2026 zitierfähig macht
Laut der Ahrefs-Untersuchung vom März 2026 (863 Tausend Keywords, 4 Millionen AI-Overview-Zitate) stehen 38 Prozent der zitierten Seiten in den organischen Top Ten, 31 Prozent jenseits der Position hundert, und YouTube liefert 5,6 Prozent aller Zitate. Laut der Messung von Seer Interactive vom April 2026 (53 Marken, 5,47 Millionen Anfragen) liegt die organische Klickrate neben einem AI Overview bei 2,36 Prozent statt 3,82, wird die Marke jedoch in der Zusammenfassung zitiert, liegt sie bei Informationsanfragen bei 2,07 Prozent statt 0,94, also mehr als doppelt so hoch. Laut Similarweb-Daten vom September 2026 leiteten KI-Oberflächen im Monatsschnitt 770,7 Millionen Besuche auf Websites, ein Zuwachs von 117,4 Prozent in einem Jahr; vom generativen KI-Traffic entfielen im Mai 2026 52,7 Prozent auf ChatGPT, 27,3 auf Gemini und 8,9 auf Claude.
Was messbar zählt: Crawlbarkeit für KI-Bots (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer); eine direkte Antwort unter jeder Überschrift; Statistiken, Zitate und Verweise mit benannter Quelle (laut der Princeton-GEO-Studie 30 bis 40 Prozent mehr Sichtbarkeit, Keyword-Stuffing nichts); Aktualität mit sichtbarem Datum; Markenerwähnungen im Web, auf YouTube und Reddit (in der Ahrefs-Korrelation über 75 Tausend Marken liegt die YouTube-Erwähnung bei 0,74, die Backlink-Zahl bei 0,19); Autorenexpertise und eigene Forschung. Schema.org und Seitengeschwindigkeit helfen der Indexierung, eine direkte Zitierwirkung hat keine Untersuchung aus 2026 nachgewiesen. Das messen wir mit Ahrefs Brand Radar: KI-Erwähnungen, Zitate, geschätzte Impressionen und Share of Voice auf ChatGPT, Google AI Overviews, AI Mode, Gemini, Perplexity, Copilot, Claude und Grok. Ausführlich auf den Seiten SEO, GEO und AEO und GEO-Optimierung.
Kennzeichnung und Herkunftsnachweis: C2PA, SynthID, Plattform-Labels
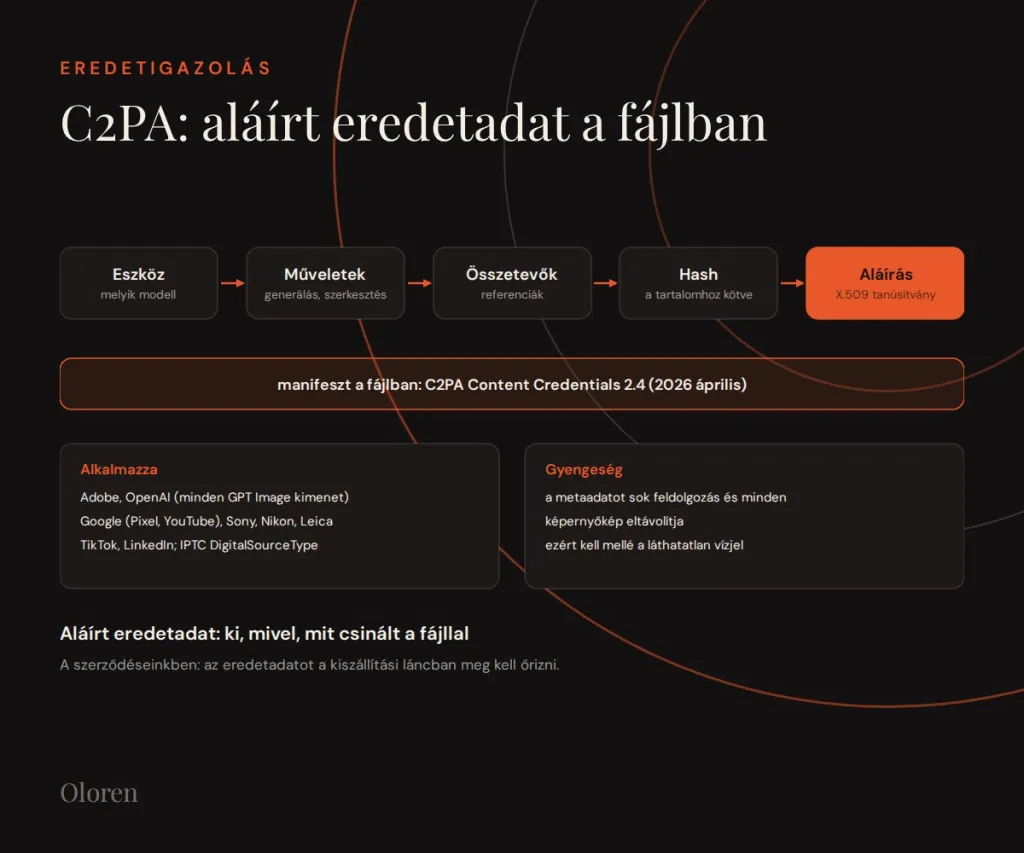
C2PA: signierte Herkunftsdaten in der Datei
C2PA Content Credentials sind ein kryptografisch signiertes Manifest in der Datei: Es hält das Werkzeug, die Bearbeitungsschritte und die Bestandteile fest, per Hash an den Inhalt gebunden und mit einem X.509-Zertifikat signiert. Version 2.4 des Standards erschien im April 2026; eingesetzt wird er von Adobe, OpenAI (jede GPT-Image-Ausgabe), Google (Pixel, YouTube), Sony, Nikon, Leica, TikTok und LinkedIn. In den IPTC-Metadaten signalisieren die Werte "trainedAlgorithmicMedia" (mit generativer KI erstellt) und "compositeWithTrainedAlgorithmicMedia" (mit generativer KI bearbeitet) des Feldes DigitalSourceType dasselbe; diese lesen Googles "About this image" und Meta aus.
Die Schwäche: Viele Verarbeitungsketten und jeder Screenshot entfernen die Metadaten. Deshalb kombiniert der EU-Praxiskodex sie mit einem unsichtbaren Wasserzeichen, und deshalb schreiben wir in unseren Verträgen vor, dass die Herkunftsdaten in der gesamten Lieferkette erhalten bleiben müssen.
SynthID: unsichtbares Wasserzeichen
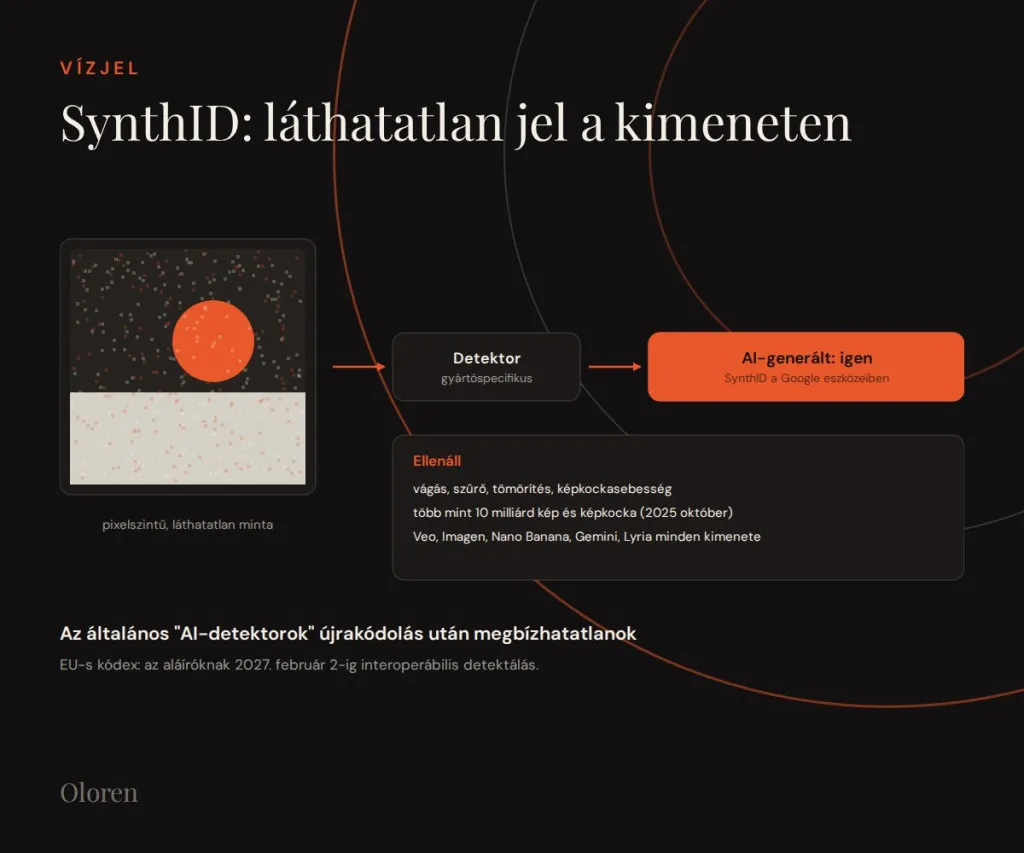
Googles SynthID bettet im Moment der Generierung ein pixelgenaues, mit bloßem Auge unsichtbares Wasserzeichen in Bild, Video, Audio und Text ein, das Zuschnitt, Filtern, Komprimierung und Änderungen der Bildrate standhält. Laut der SynthID-Image-Studie vom Oktober 2025 haben mehr als 10 Milliarden Bilder und Einzelbilder ein solches Zeichen erhalten; jede Ausgabe von Veo, Imagen, Nano Banana, Gemini und Lyria ist mit Wasserzeichen versehen, und die Gemini-App kann es prüfen. Die Detektoren sind herstellerspezifisch: SynthID erkennt Googles Werkzeug, die Ausgabe von OpenAI der Klassifikator von OpenAI; allgemeine "KI-Detektoren" bauen auf gelernten Artefakten auf und sind nach einer Neukodierung unzuverlässig. Die Unterzeichner des EU-Kodex müssen bis zum 2. Februar 2027 eine interoperable Erkennung gewährleisten.
Plattform-Labels 2026
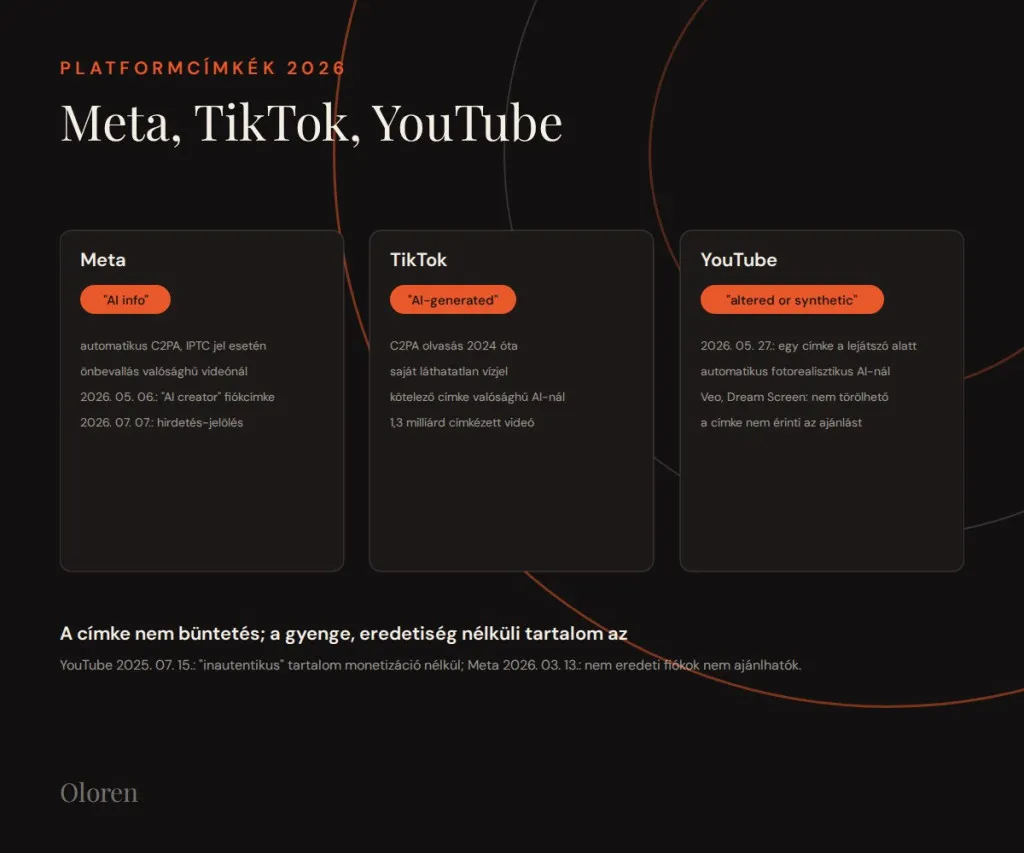
Meta (Facebook, Instagram, Threads): automatisches "AI info"-Label bei C2PA- oder IPTC-Signal, verpflichtende Selbstauskunft bei realistischen KI-Videos und KI-Audio; ab dem 6. Mai 2026 freiwillige Kennzeichnung "AI creator" auf Kontoebene bei Instagram ohne Reichweitenstrafe; ab dem 7. Juli 2026 zeigt "About this ad" bei Anzeigen, ob das Werbemittel mit generativen Werkzeugen von Meta oder Dritten erstellt oder verändert wurde. TikTok: liest C2PA seit 2024, setzt ein eigenes unsichtbares Wasserzeichen auf KI-Inhalte, verpflichtendes Label bei realistischen KI-Bildern und KI-Audio, hat mehr als 1,3 Milliarden Videos gekennzeichnet. YouTube: ab dem 27. Mai 2026 ein einziges Label "altered or synthetic content" unter dem Player (bei Shorts eingeblendet), automatische Kennzeichnung bei fotorealistischen KI-Inhalten oder C2PA-Daten; das Label auf Veo- und Dream-Screen-Inhalten lässt sich nicht entfernen; das Label allein beeinflusst weder Empfehlung noch Einnahmen.
Was sie dagegen beeinflusst: YouTube schließt seit dem 15. Juli 2025 "inauthentische", massenhaft produzierte Inhalte von der Monetarisierung aus, Meta macht seit dem 13. März 2026 Konten, die überwiegend nicht originäre Inhalte veröffentlichen, nicht mehr empfehlbar. Das Label ist also keine Strafe, minderwertiger KI-Content ohne Originalität dagegen schon.
Rechtliche Regulierung 2026: EU, Ungarn, Welt
EU-KI-Verordnung, Artikel 50: gilt ab dem 2. August 2026
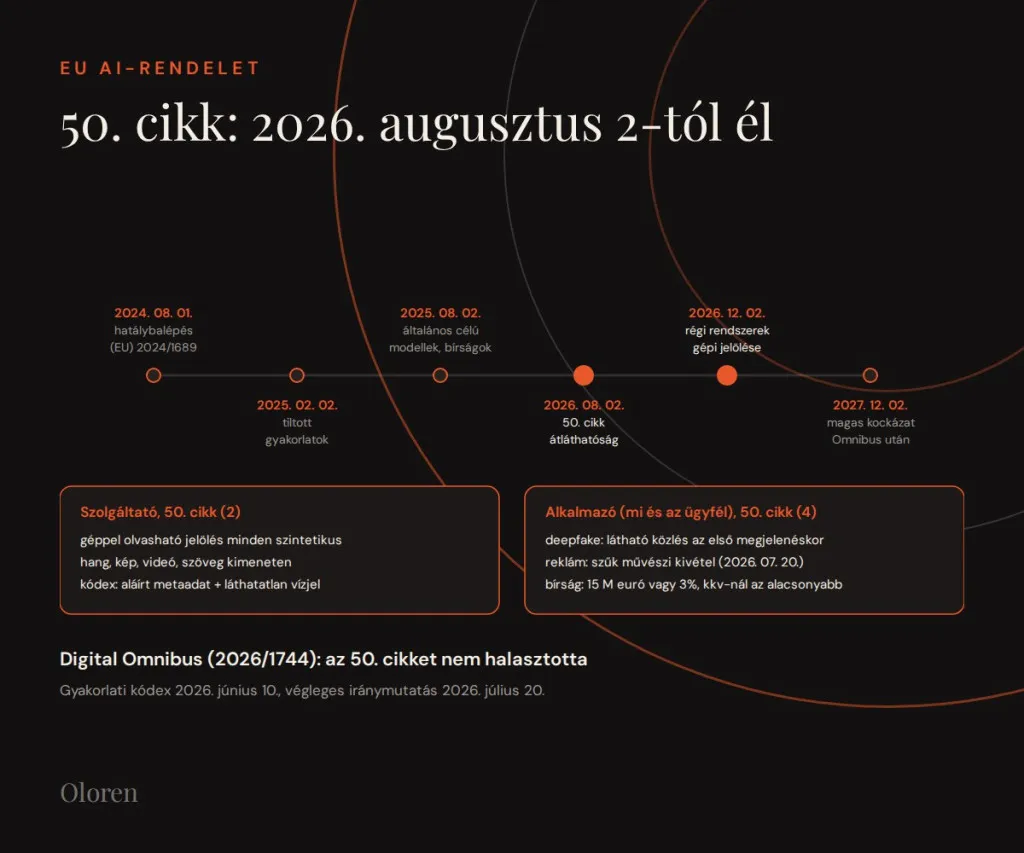
Die Verordnung (EU) 2024/1689 (KI-Verordnung, AI Act) trat am 1. August 2024 in Kraft; die verbotenen Praktiken gelten seit dem 2. Februar 2025, die Pflichten für Modelle mit allgemeinem Verwendungszweck seit dem 2. August 2025, die Transparenzpflichten des Artikels 50 ab dem 2. August 2026. Der am 27. Juli 2026 in Kraft getretene Digital Omnibus (Verordnung (EU) 2026/1744) hat Artikel 50 nicht verschoben, sondern nur für die maschinelle Kennzeichnung generativer Systeme, die vor dem 2. August 2026 bereits auf dem Markt waren, eine Schonfrist bis zum 2. Dezember 2026 eingeräumt, die Fristen für Hochrisikosysteme auf den 2. Dezember 2027 beziehungsweise den 2. August 2028 verschoben und verbietet ab dem 2. Dezember 2026 "Entkleidungs"-Systeme und Bildgeneratoren, die Kinder missbrauchen.
Artikel 50 Absatz 2 verpflichtet den Anbieter: Synthetische Audio-, Bild-, Video- und Textausgaben müssen in maschinenlesbarer Form gekennzeichnet und erkennbar gemacht werden. Absatz 4 gilt für den Betreiber, also für uns und unsere Kunden: Wer einen Deepfake (einen echt wirkenden Inhalt, der einer existierenden Person, einem Gegenstand, Ort oder Ereignis ähnelt) erstellt oder verändert, muss offenlegen, dass er künstlich erzeugt wurde; bei künstlerischen, satirischen und fiktionalen Werken genügt eine Offenlegung, die den Genuss des Werks nicht beeinträchtigt. Der am 10. Juni 2026 veröffentlichte Praxiskodex der Kommission erwartet von Anbietern mindestens zwei maschinelle Verfahren (signierte Metadaten vom Typ C2PA und ein unsichtbares Wasserzeichen), von Betreibern ein bei der ersten Anzeige sichtbares, einheitliches EU-Symbol oder den Hinweis "KI-generiert" beziehungsweise "KI-verändert". Die endgültigen Leitlinien vom 20. Juli 2026 behandeln Werbung eng: Rein informative oder kommerzielle Inhalte können sich nicht auf die künstlerische Ausnahme berufen, und eine KI-Werbung, die das Produkt abweichend von der Realität zeigt, braucht ein Deepfake-Label. Die Geldbuße für Verstöße gegen Artikel 50 beträgt bis zu 15 Millionen Euro oder 3 Prozent des weltweiten Umsatzes, bei KMU der niedrigere der beiden Beträge.
Urheberrecht: Wer ist der Urheber, und was ist geschützt?
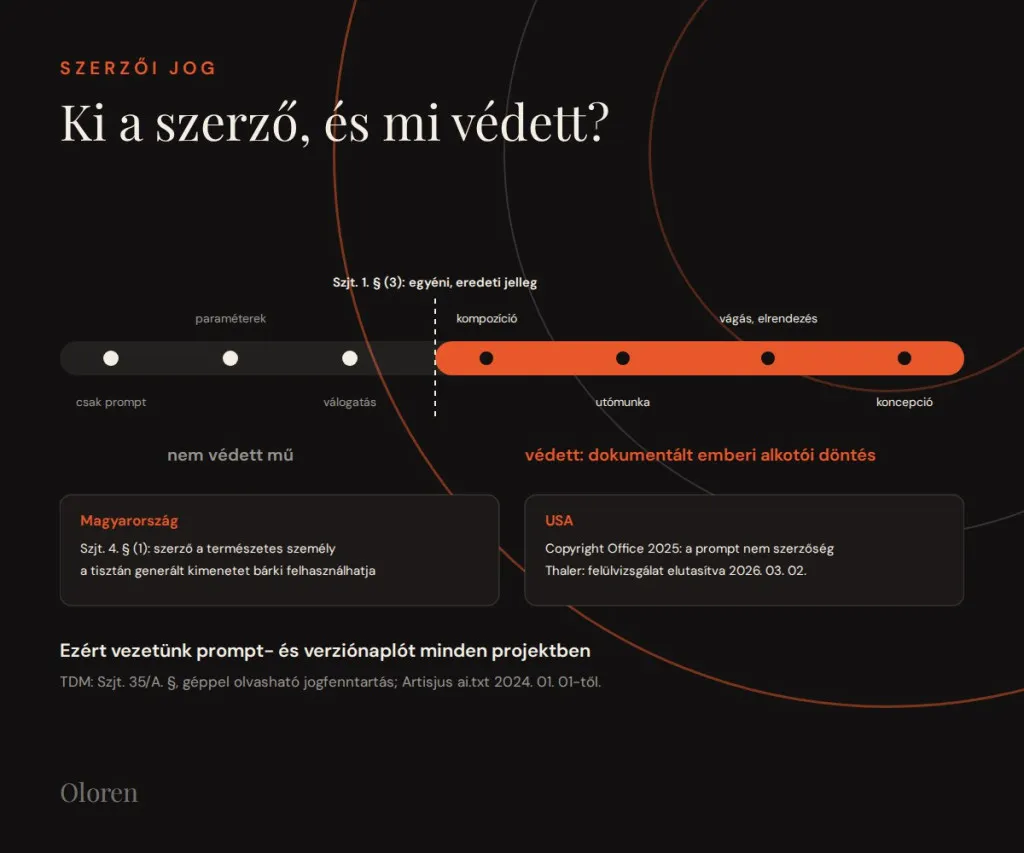
Nach § 1 Absatz 3 des ungarischen Urheberrechtsgesetzes (Gesetz LXXVI von 1999) setzt der Schutz einen individuellen, originellen Charakter voraus, der aus der geistigen Tätigkeit des Urhebers hervorgeht, und nach § 4 Absatz 1 ist Urheber, wer das Werk geschaffen hat, also eine natürliche Person. Eine rein maschinell generierte Ausgabe ist damit kein geschütztes Werk: Jeder, auch der Wettbewerber, darf sie frei nutzen. In den USA gilt dieselbe Regel: Laut dem Bericht des Copyright Office vom Januar 2025 begründet ein Prompt allein keine Urheberschaft, und im Fall Thaler lehnte der Supreme Court am 2. März 2026 die Überprüfung ab, das Erfordernis menschlicher Urheberschaft ist damit endgültig.
Was das Ergebnis schützbar macht, ist die dokumentierte menschliche kreative Entscheidung: Konzept, Komposition, iterative Steuerung, Auswahl, Nachbearbeitung, Schnitt, Anordnung. Deshalb führen wir in jedem KI-Projekt ein Prompt- und Versionsprotokoll, und deshalb enthält das fertige Material immer eine menschliche kreative Ebene. In der EU erlaubt Artikel 4 der Richtlinie 2019/790 (§ 35/A des ungarischen Urheberrechtsgesetzes) Text- und Data-Mining, sofern der Rechteinhaber seine Rechte nicht maschinenlesbar vorbehalten hat; Artisjus hat ab dem 1. Januar 2024 einen kollektiven Vorbehalt per ai.txt-Datei erklärt. Das Europäische Parlament nahm am 10. März 2026 den Voss-Bericht an (Vergütung, Transparenz, widerlegbare Nutzungsvermutung), die Kommission startete am 13. Mai 2026 eine Konsultation, und vor dem Europäischen Gerichtshof läuft auf ungarische Vorlage der erste urheberrechtliche Fall zu generativer KI (Like Company gegen Google, C-250/25, Verhandlung am 10. März 2026).
Ungarische Behörde, Persönlichkeitsrecht, Datenschutz
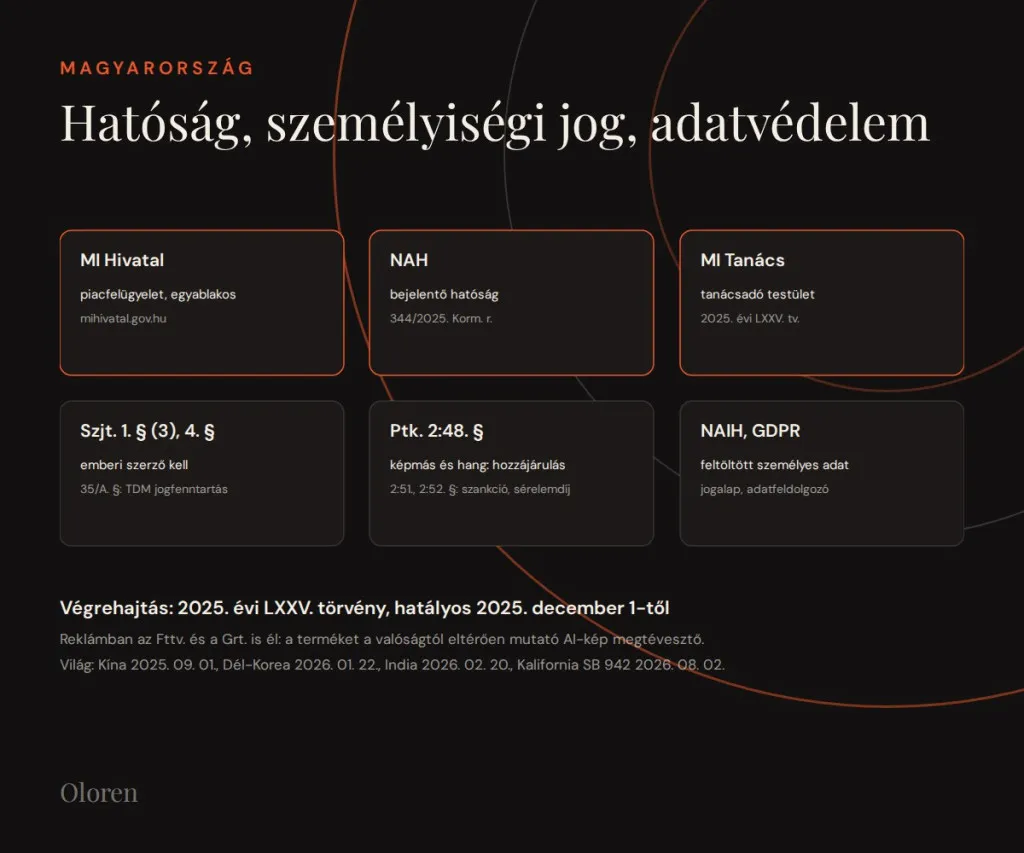
Das Gesetz LXXV von 2025 (in Kraft seit dem 1. Dezember 2025) und die Regierungsverordnung 344/2025 (X. 31.) setzen die KI-Verordnung um: Notifizierende Behörde ist die Nationale Akkreditierungsbehörde, Marktüberwachungsbehörde und zugleich zentrale Anlaufstelle ist das Amt für Künstliche Intelligenz (mihivatal.gov.hu), das auch das regulatorische Reallabor betreibt; daneben berät der Ungarische Rat für Künstliche Intelligenz. Laut der Information des Amtes muss der Anbieter spätestens bei der ersten Interaktion textlich, visuell oder akustisch über den KI-Einsatz informieren und die Ausgabe in maschinenlesbarer Form kennzeichnen.
Bildnis und Stimme sind nach § 2:48 Absatz 1 des ungarischen Bürgerlichen Gesetzbuchs an eine Einwilligung gebunden, eine Verletzung zieht objektive Sanktionen (§ 2:51) und eine Entschädigung für erlittenes Unrecht (§ 2:52) nach sich. Wer ein Kundenfoto oder eine erkennbare Person in einen Generator hochlädt, verarbeitet personenbezogene Daten: Dafür braucht es eine DSGVO-Rechtsgrundlage und Auftragsverarbeitungsbedingungen, die ungarische Datenschutzbehörde NAIH verhängte bereits 2022 eine Geldbuße von 250 Millionen Ft für KI-gestützte Stimmanalyse. In der Werbung gelten die allgemeinen Regeln des ungarischen Gesetzes gegen unlautere Geschäftspraktiken und des Werbegesetzes: Ein KI-Bild, das das Produkt abweichend von der Realität zeigt, ist irreführend, auch wenn es gekennzeichnet ist. Im Rest der Welt geht es in dieselbe Richtung: China schreibt seit dem 1. September 2025 explizite und implizite Kennzeichnung vor, Südkorea seit dem 22. Januar 2026, Indien seit dem 20. Februar 2026; in den USA verlangt der TAKE IT DOWN Act seit dem 19. Mai 2026 von den Plattformen eine Entfernung innerhalb von 48 Stunden, das kalifornische Gesetz SB 942 ab dem 2. August 2026 eine Kennzeichnung in den Metadaten, und der NO FAKES Act passierte im Juni 2026 den Justizausschuss des Senats.
Die Gerichtsverfahren 2025 und 2026, die die Praxis prägen
| Verfahren | Gericht, Datum | Entscheidung und Stand |
|---|---|---|
| Getty Images gegen Stability AI | England, High Court, 4. November 2025 | das Modell ist keine "rechtsverletzende Kopie", weil es die Werke nicht speichert; begrenzter markenrechtlicher Erfolg; Getty kann Berufung einlegen |
| GEMA gegen OpenAI | LG München I, 11. November 2025 | das Memorieren von Liedtexten ist Vervielfältigung, die TDM-Schranke greift nicht; Berufung vor dem OLG München |
| GEMA gegen Suno | LG München I, 31. Juli 2026 | Training, Memorieren, Output und öffentliche Wiedergabe rechtsverletzend; das Fair-Use-Argument abgewiesen |
| Bartz gegen Anthropic | N.D. Cal., 23. Juni 2025 und 22. Juli 2026 | Training auf rechtmäßig erworbenen Büchern ist Fair Use, Raubkopien nicht; Vergleich über 1,5 Milliarden Dollar genehmigt |
| Kadrey gegen Meta | N.D. Cal., 25. Juni 2025 | auf Basis der vorgelegten Beweise Fair Use, ausdrücklich kein Präzedenzfall |
| Thomson Reuters gegen Ross | D. Del. Februar 2025; Verhandlung 3rd Cir. 11. Juni 2026 | kein Fair Use bei nicht generativer Rechts-KI; Berufungsentscheidung bis Ende 2026 erwartet |
| NYT und andere gegen OpenAI, Microsoft | S.D.N.Y., verbundenes Verfahren | der Großteil der Klage hat den Abweisungsantrag überstanden; Summary-Judgment-Phase ab 4. September 2026 |
| Disney, Universal, Warner gegen Midjourney | C.D. Cal., Juni und September 2025 | Generierung geschützter Figuren; Anträge bis 23. November 2026, Verhandlung 2027 |
| Thaler gegen Perlmutter | US Supreme Court, 2. März 2026 | Überprüfung abgelehnt: KI kann kein Urheber sein |
| Like Company gegen Google | Europäischer Gerichtshof, C-250/25, ungarische Vorlage | Chatbot und Presseinhalte, Training als Vervielfältigung, TDM-Schranke; Urteil 2027 erwartet |
Das Muster ist klar: In den USA galt das Training auf rechtmäßig erworbenem Material bisher als Fair Use, Piraterie-Quellen nicht; in Europa sind Memorieren und ähnlicher Output Rechtsverletzungen, die Rechtmäßigkeit des Trainings hängt von der Quelle ab. In der Werbeproduktion denken wir deshalb vom Output her: Wir generieren keine erkennbaren geschützten Werke, Figuren oder Stimmen von Künstlern und wählen Werkzeuge, die auf lizenzierten Daten trainiert wurden und mit Unternehmensbedingungen sowie Rechtsgarantie arbeiten, wo dies verfügbar ist.
Glossar
| Begriff | Bedeutung |
|---|---|
| Prompt | Text- oder Bildanweisung, aus der das Modell generiert. In Tokens zerlegt gelangt sie als Vektor ins Netzwerk. |
| Token | Die kleinste Einheit des Modells: Wortteil, Bildausschnitt oder Audio-Frame. |
| Embedding (Einbettung) | Die Zahlenvektor-Darstellung eines Tokens oder eines Bildes; ähnliche Bedeutung ergibt nahe Vektoren. |
| Latenter Raum | Die vom VAE komprimierte interne Darstellung, in der die Diffusion läuft. |
| Diffusion | Verrauschen und schrittweises Entrauschen; die Grundlage heutiger Bildgeneratoren. |
| Flow Matching | Ein auf gerader Bahn gelerntes Geschwindigkeitsfeld zwischen Rauschen und Bild; weniger Schritte. |
| DiT, MMDiT | Diffusions-Transformer; die Variante, die Bild- und Text-Tokens in gemeinsamer Attention verarbeitet. |
| Guidance (CFG) | Verstärkung der Prompt-Wirkung über die Differenz zwischen bedingter und unbedingter Vorhersage. |
| Seed | Der Zufallskeim des Ausgangsrauschens; gleicher Seed und gleiche Einstellungen ergeben dasselbe Bild. |
| ControlNet, IP-Adapter, LoRA | Steuerzweige und kleine Adapter zum Festlegen von Komposition, Referenzbild und Stil. |
| 3D VAE | Ein räumlich und zeitlich komprimierender Autoencoder für Video. |
| Neuronaler Codec, RVQ | Ein Kompressor, der Audio in ganzzahlige Tokens zerlegt; die Eingabe der Musikmodelle. |
| Transformer, Attention | Der Baustein der Sprachmodelle und der meisten generativen Modelle; das gewichtete "Hinschauen" der Tokens aufeinander. |
| RLHF, DPO | Nachtraining auf Basis menschlicher Präferenzen; die Erziehung des Modells zum "Assistenten". |
| RAG | Retrieval-gestützte Generierung: das Modell antwortet auf Basis gefundener Textstellen, mit Quellenangabe. |
| Halluzination | Eine wahrscheinliche, aber falsche Aussage; ein natürlicher Fehler der Vorhersage, durch Verankerung reduzierbar. |
| GEO, AEO | Generative und Answer Engine Optimization: damit KI-Suchmaschinen unsere Seite zitieren. |
| Query Fan-out | Die Aufteilung der Frage in mehrere Untersuchen in KI-Suchmaschinen. |
| C2PA | Signierter Herkunftsdaten-Standard in der Datei. |
| SynthID | Das unsichtbare Wasserzeichen von Google für generierte Bilder, Videos, Audio und Texte. |
| Deepfake (AI Act Art. 3 Nr. 60) | Generierter oder manipulierter Inhalt, der einer existierenden Person, Sache, einem Ort oder Ereignis ähnelt und echt wirkt. |
| Anbieter und Betreiber | Die zwei Akteure des AI Act: wer das System entwickelt und wer es nutzt; der Werbeproduzent ist Betreiber. |
| TDM-Schranke | Die urheberrechtliche Erlaubnis zum Text- und Data-Mining, durch maschinenlesbaren Nutzungsvorbehalt ausschließbar (ungarisches UrhG, § 35/A). |